Ist Jev wirklich gut? Ein Feldtest auf frischen Daten
TypeSafes Jev im Feldtest gegen kleine LLMs, offene Alternativen und das alte Rezept aus Embeddings und Labels, auf frischen Daten aus dem September 2026.
TL;DR. Ein technischer Beitrag, der tief in Machine Learning einsteigt und Jev evaluiert, vor allem für Leute, die selbst Modelle bauen oder auswählen.
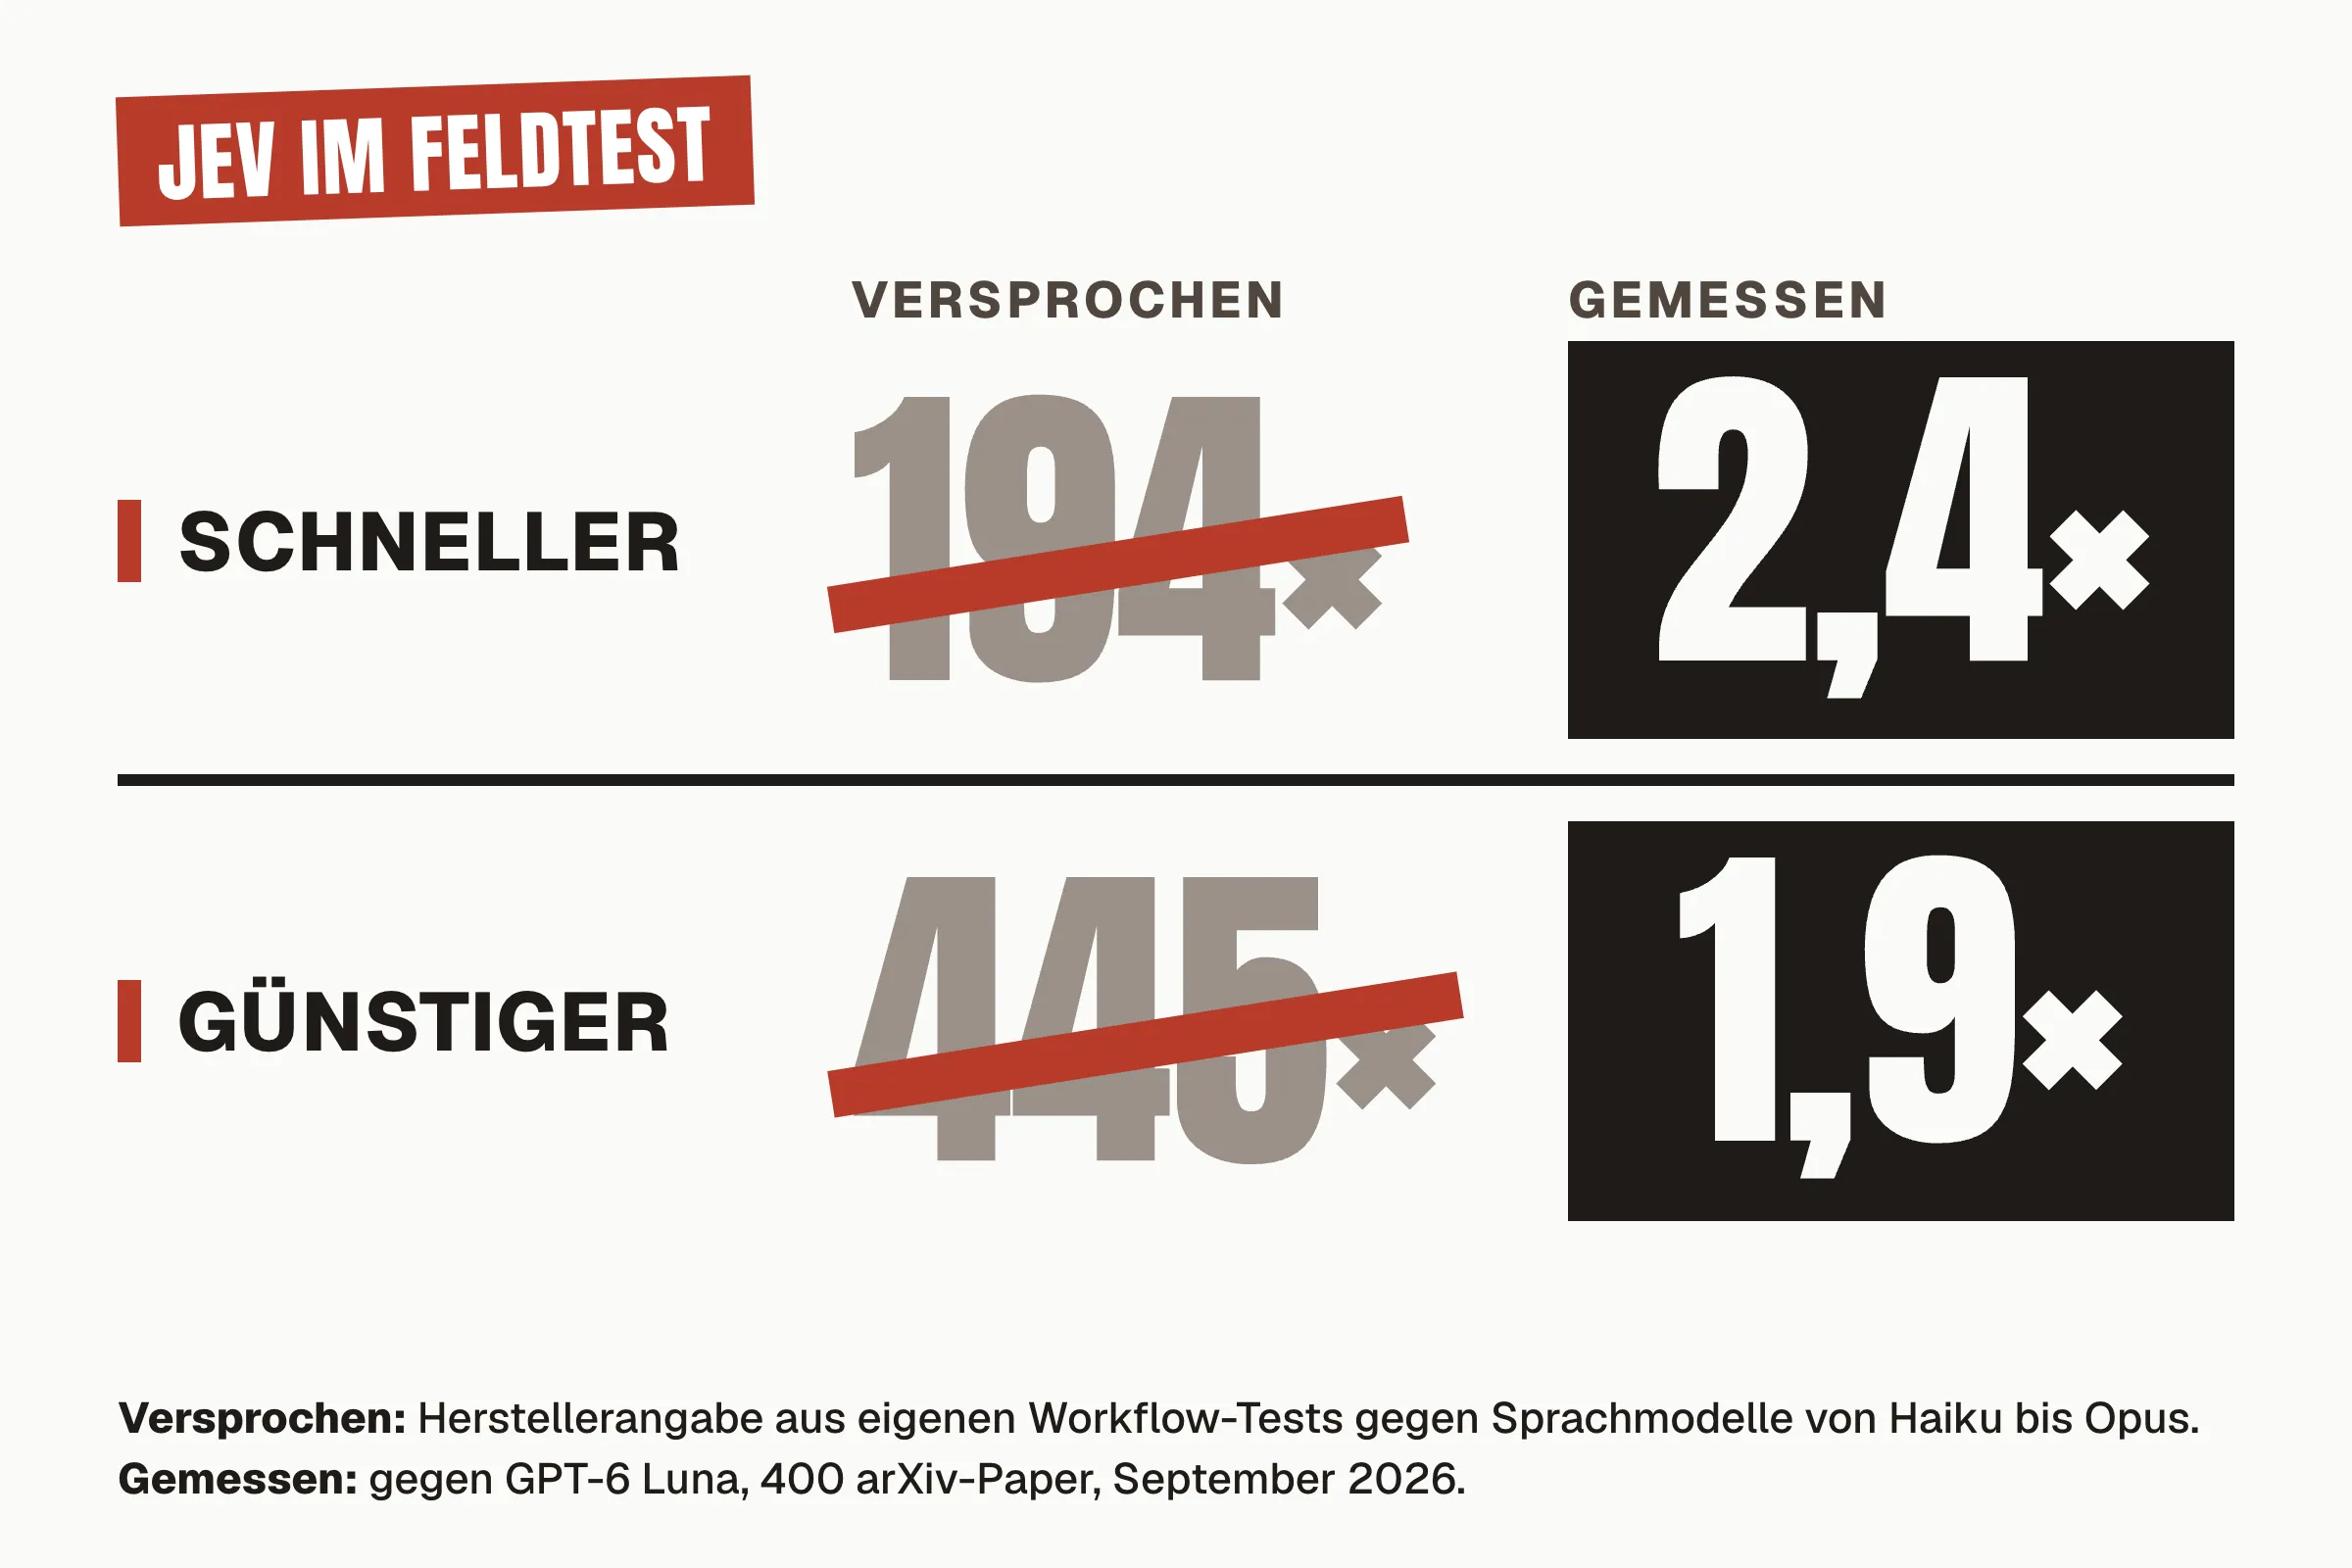
- Gegen kleine LLMs: Jev ist nicht messbar besser oder schlechter, aber günstiger und schneller. Die Werbezahlen stammen aus Herstellertests gegen deutlich teurere Modelle.
- Gegen offene Alternativen: Jev liegt deutlich vorn.
- Mit Labels: Ein einfacher Klassifikator auf modernen Embeddings holt Jev mit wenigen hundert Beispielen fast ein und ist dabei besser kalibriert.
- Wahrscheinlichkeiten: Brauchbar, aber oft gesättigt und abhängig davon, wie man fragt.
- Fazit: Ein guter Zero-Shot-Klassifikator für den Kaltstart, kein neues Prinzip.
Transparenzhinweis: Dieser Text wurde mit AI geschrieben, und die Experimente haben AI-Agenten ausgeführt. Ich habe beides geplant, überwacht und geprüft. Wie das ablief, steht am Ende. Code, Daten und jede Modellantwort liegen im verlinkten Repository.
Am 15. September 2026 stellte TypeSafe sein erstes Modell vor. Es heißt Jev und ist nach Angaben des Herstellers ein „System One“-Modell: Es schreibt keine Texte, es entscheidet. Man gibt ihm einen Text und eine Frage mit festen Antwortmöglichkeiten, und es liefert die Antwort samt Wahrscheinlichkeit zurück. Dazu kamen zwei Zahlen, die schnell die Runde machten: 193,6-mal schneller und 444,6-mal günstiger als ein großes Sprachmodell. (TypeSafe, Tom’s Hardware)
Die Ankündigung verbreitete sich schnell. Ich habe trotzdem die Stirn gerunzelt, und nicht als Einziger. (KDnuggets) Ein Modell, das ohne eigene Trainingsdaten aus einer Liste von Kategorien wählt und dazu eine Wahrscheinlichkeit nennt, heißt seit Langem Zero-Shot-Klassifikator. Wer sich auf LinkedIn umschaut, könnte trotzdem meinen, Klassifikation sei gerade neu erfunden worden. Da trennt sich die Spreu vom Weizen: Wer schon einmal mit Machine Learning gearbeitet hat, erkennt das Grundprinzip sofort wieder.
Zero-Shot-Klassifikation hat also einen neuen Namen bekommen. In unserer Branche ist das oft der aufwendigste Teil der Innovation.
Das allein wäre kein Grund für einen langen Text. Neue Namen für alte Ideen sind nicht automatisch schlechte Produkte, und die Zahlen von TypeSafe lassen sich prüfen. Routing-Entscheidungen gehören zu meiner täglichen Arbeit. Ich verantworte eine Routing-Pipeline im Kundensupport, die ich auf 5 Millionen Tokens pro Minute skaliert habe, und vor längerer Zeit habe ich mit fse eine Bibliothek für Embeddings veröffentlicht. Also habe ich die Zahlen geprüft, mit einer praktischen Frage: Was kaufen Sie sich mit einem Zero-Shot-Modell ein, und was ändert sich, sobald Sie gelabelte Beispiele haben?
Wie Klassifikation funktioniert
Eine Klassifikation ordnet einer Eingabe eine von mehreren Kategorien zu. Ist diese E-Mail eine Kündigung, eine Rechnungsfrage oder ein Upgrade? Gehört dieses Paper zur Robotik oder zur Bildverarbeitung? Ein Modell gibt dafür meist eine Wahrscheinlichkeit pro Kategorie aus. Über einen Schwellenwert entscheiden Sie, ab wann das System allein entscheidet und wann ein Mensch draufschaut.
Es gibt zwei grundsätzliche Wege dorthin. Beim Supervised Learning trainieren Sie ein Modell mit Beispielen, deren richtige Kategorie Sie kennen, also mit Labels. Das reicht von TF-IDF, einer Gewichtung von Wörtern nach ihrer Seltenheit, mit einer logistischen Regression bis zu Embeddings. Das sind Zahlenvektoren, die ein Sprachmodell für einen Text berechnet. Auf ihnen lernt dann ein einfacher Klassifikator. Beim Zero-Shot-Ansatz gibt es keine Beispiele. Das Modell bekommt nur die Beschreibung der Kategorien und muss aus seinem Vorwissen schließen. Mit Unsupervised Learning, bei dem ein Verfahren ganz ohne Labels Strukturen in Daten sucht, etwa beim Clustering, hat das übrigens nichts zu tun. Die Kategorien sind vorgegeben, nur die Beispiele fehlen.
Dass neuronale Netze Entscheidungen ausgeben, ist dabei der Normalfall. Die Softmax-Schicht am Ende eines Klassifikators ist ihre übliche Ausgabeform. Auch ein großes Sprachmodell klassifiziert streng genommen bei jedem einzelnen Token, also Wortteil, nur eben über ein Vokabular von hunderttausend Einträgen.
Bleibt die Frage, ob die Wahrscheinlichkeiten stimmen. Das heißt Kalibrierung. Ein Modell ist gut kalibriert, wenn seine Sicherheit hält, was sie verspricht: Sagt es bei hundert Entscheidungen jeweils 90 Prozent, sollten ungefähr 90 davon richtig sein, nicht 70 und nicht 99. Nur dann können Sie auf dieser Zahl einen Schwellenwert bauen, etwa „unter 80 Prozent Sicherheit prüft ein Mensch“. Dass moderne neuronale Netze dabei systematisch zu selbstsicher sind, ist spätestens seit 2017 gut dokumentiert. (Guo et al.)
Was Jev ist und was daran neu sein soll
Jev bekommt einen „Zustand“, TypeSafes etwas vornehmeres Wort für die Eingabe, meist einen Text, und eine oder mehrere typisierte Fragen. Zurück kommen die Antwort und Wahrscheinlichkeiten, aber keine Begründung. Mehrere Fragen zum selben Text lassen sich in einem Aufruf stellen. Wie das Modell intern aufgebaut ist und wie groß es ist, hat TypeSafe nicht veröffentlicht. (TypeSafe Docs)
Die drei Fragetypen sind der Kern der Schnittstelle, und sie tauchen in jedem Vergleich wieder auf:
- Choice wählt eine von bis zu 255 Optionen, die Sie beim Aufruf festlegen, und liefert eine Wahrscheinlichkeitsverteilung über alle Optionen. Das ist klassische Klassifikation mit mehreren Kategorien: Welche Abteilung bekommt dieses Ticket?
- Noul beantwortet eine Ja-Nein-Frage mit der Wahrscheinlichkeit für Ja. Das ist binäre Klassifikation: Enthält diese E-Mail eine Kündigung?
- Score ordnet etwas auf einer Skala mit festen Stufen ein und liefert eine Wahrscheinlichkeit pro Stufe. Das ist ordinale Klassifikation: Wie dringend ist dieser Fall, von 0 bis 4?
Keiner dieser drei Typen ist neu. Neu ist, dass ein einzelnes Modell alle drei über eine gemeinsame Schnittstelle bedient.
Die Begründung des Herstellers ist interessanter als das Produktblatt. Große Sprachmodelle durchlaufen nach dem Vortraining meist ein Verfahren namens RLHF, Reinforcement Learning from Human Feedback: Menschen bewerten Antworten, und das Modell lernt, Antworten zu geben, die Menschen bevorzugen. Diogo Almeida, Mitautor von InstructGPT, einer der Arbeiten, die RLHF bekannt gemacht haben, und Gründer von TypeSafe, argumentiert, dass Sprachmodelle genau dadurch gefällig und zu selbstsicher werden. Für einen Assistenten sei das in Ordnung, für automatische Entscheidungen nicht. TypeSafe trainiert deshalb mit einem eigenen Verfahren, RLCD, darauf, dass die Wahrscheinlichkeiten mit der Realität übereinstimmen. Die Abkürzung steht für Reinforcement Learning for Calibrated Decisions. Ein technisches Paper dazu gibt es bisher nicht. (Vortrag von Diogo Almeida, AI Engineer World’s Fair, MarkTechPost)
Ist das der richtige Ansatz? Die Diagnose hat einen belastbaren Kern. OpenAI hat schon im Bericht zu GPT-4 gezeigt, dass das vortrainierte Modell gut kalibriert war und die Kalibrierung nach dem Nachtraining schlechter wurde. (OpenAI, GPT-4 Technical Report) Die Therapie ist eine Wette. Kalibrierung lässt sich auch nachträglich herstellen, mit Verfahren wie Temperature Scaling, und das seit Jahren. Ob es dafür ein eigenes Trainingsverfahren braucht, zeigt sich nur an den Ergebnissen. Dazu unten mehr.
Die Idee, ohne Trainingsdaten aus Kategorien zu wählen, ist jedenfalls deutlich älter als Jev.
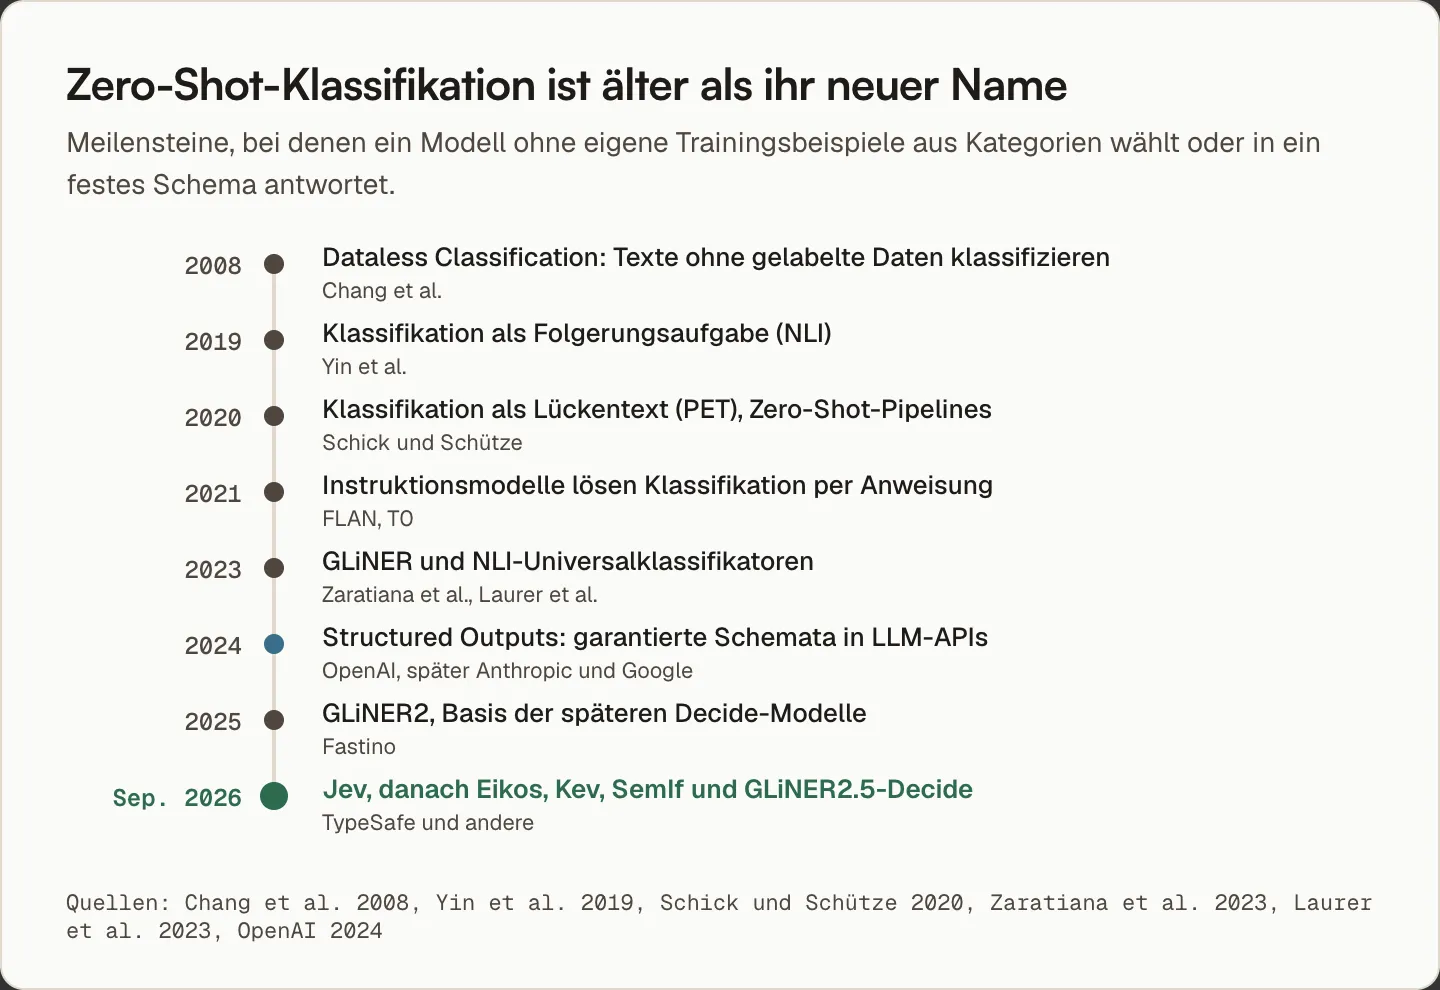
Chang und Kollegen klassifizierten 2008 Texte ohne gelabelte Daten. 2019 formulierten Yin und Kollegen Klassifikation als Folgerungsaufgabe, auf Englisch Natural Language Inference (NLI): Folgt aus dem Text der Satz „Es geht um Sport“? Auf dieser Idee beruhen die Zero-Shot-Pipelines, die man in vielen Anleitungen findet. GLiNER folgte 2023. Seine Nachfolger stecken heute in einem der offenen Konkurrenten von Jev. Strukturierte Ausgaben, also Antworten, die garantiert einem vorgegebenen Schema folgen, bieten inzwischen die großen Anbieter an, darunter OpenAI, Anthropic und Google. (Chang et al., Yin et al., GLiNER, OpenAI)
Neu an Jev kann also nicht die Aufgabe sein. Neu sein können das Trainingsziel, der Preis, das Tempo und das Versprechen, dass die Wahrscheinlichkeiten stimmen. Das lässt sich messen.
Kurz nach dem Start erschienen die ersten offenen Alternativen: Eikos, Kev, SemIf, dazu Fastinos GLiNER2.5-Decide. Andere wie GLiClass oder Laya gab es schon vorher. Nach zwei Wochen gab es also mehrere Alternativen, deren Entwickler Jev offen herausfordern. Ob der Vorsprung hält, zeigt der Test.
Der Test: frische Daten, fremde Labels
Das größte Problem bei solchen Vergleichen sind die Testdaten. Öffentliche Benchmarks wie AG News stecken nachweislich im Training einiger großer Sprachmodelle. Ein Test, dessen Antworten das Modell schon kennt, misst nichts. (Golchin und Surdeanu) Selbst zu labeln kam für mich nicht in Frage, weil meine Labels dann das Ergebnis mitbestimmt hätten. Außerdem habe ich in meinem Leben schon über 15.000 Tweets gelabelt. Einmal reicht. Wer das schon einmal gemacht hat, weiß, wovon ich spreche.
Ich habe deshalb Daten verwendet, deren Label eine Institution vergeben hat, bevor ein Modell sie sehen konnte. Die Hauptaufgabe sind 400 arXiv-Paper aus dem September 2026, 50 aus jeder von acht Informatik-Kategorien: Sprache, Bildverarbeitung, Sicherheit, Robotik, Datenbanken, Software Engineering, Mensch-Computer-Interaktion und verteiltes Rechnen. Das Label ist die Hauptkategorie, die die Autoren gewählt und die Moderation bestätigt hat. Ein Beispiel, gekürzt:
Bridge3D: Enabling Vision-Language-Action Models to See and Act in 3D

Vision-Language-Action (VLA) models have demonstrated remarkable generalization
in robotic manipulation via large-scale multimodal pretraining. However, ...

Label: cs.RO (Robotics)
Dazu kommen 358 Dokumente aus dem Federal Register, dem amtlichen Mitteilungsblatt der US-Bundesbehörden, mit einer von sechs ausgebenden Behörden als Label. Die Namen der Behörden habe ich im Text maskiert:
Airworthiness Directives; Bombardier, Inc., Airplanes

The [AGENCY] proposes to adopt a new airworthiness directive (AD) for all
Bombardier, Inc., Model BD-100-1A10 airplanes. ...

Label: FAA
Beides sind Choice-Fragen. Den Abschluss bilden vier Sorten konstruierter Testfälle, deren richtige Antwort durch ihre Konstruktion feststeht. Zwei davon sind Noul-Fragen: eine Urne mit sieben roten und drei blauen Kugeln und die Frage, ob die gezogene Kugel rot ist, und ein langer Verwaltungstext mit der Frage, ob er irgendwo eine Kündigung enthält. Score-Fragen habe ich nicht getestet. Dazu unten mehr.
Zwei Einschränkungen gehören gleich hierher. Die Daten sind jünger als alle offengelegten Trainingsstichtage der getesteten Sprachmodelle. Jev, Gemini und die offenen Modelle legen ihre Stichtage nicht offen. Und die Kategorie eines Papers ist eine Entscheidung der Autoren zwischen sich überschneidenden Gebieten. Ein Paper über Fuzzing, also automatisiertes Testen mit zufälligen Eingaben, kann unter Sicherheit oder unter Software Engineering stehen. Bei 16 der 400 Paper wählten alle fünf getesteten API-Modelle übereinstimmend eine andere Kategorie als die Autoren. Hundert Prozent sind bei dieser Aufgabe also nicht realistisch.
Insgesamt liefen 23 Systeme. Das Protokoll stand vor dem ersten Aufruf fest. Jede Abweichung davon ist im Repository dokumentiert, und alles, was ich erst nach den ersten Ergebnissen ergänzt habe, ist als nachträglich gekennzeichnet. Die Rechnung für alle API-Aufrufe lag bei rund 5,30 US-Dollar.
Die Systeme sind sehr verschieden, deshalb hier die wichtigsten auf einen Blick:
| System | Art | Zugang | Kontext | Eingaben | Wahrscheinlichkeit | Begründung | Kosten pro 1.000 |
|---|---|---|---|---|---|---|---|
| Jev 1.13 | Decision-Modell | nur API | 32.000 Tokens | Text | ja, vom Modell | nein | 0,035 $ |
| GPT-6 Luna | Sprachmodell | API | 1 Mio. Tokens | Text, Bild, PDF | nur selbst geschätzt | ja | 0,065 $ |
| Gemini 3.5 Flash-Lite | Sprachmodell | API | 1 Mio. Tokens | Text, Bild, PDF, Audio, Video | nur selbst geschätzt | ja | 0,21 $ |
| Claude Haiku 4.5 | Sprachmodell | API | 200.000 Tokens | Text, Bild, PDF | nur selbst geschätzt | ja | 0,89 $ |
| Claude Sonnet 5 | Sprachmodell | API | 1 Mio. Tokens | Text, Bild, PDF | nur selbst geschätzt | ja | 2,48 $ |
| GLiNER2.5-Decide | offener Encoder | lokal | 512 Tokens trainiert, Zerlegung möglich | Text | ja | nein | eigene Hardware |
| Laya | offener Encoder | lokal | 512 Tokens | Text | ja | nein | eigene Hardware |
| DeBERTa-v3 NLI | offener Encoder | lokal | 512 Tokens | Text | ja | nein | eigene Hardware |
| Embeddings + logistische Regression | Supervised, braucht Labels | API oder lokal | 32.000 Tokens | Text | ja | nein | 0,003 $ |
Verglichen wird, was alle können: gleicher Text, gleiche Kategorien, eine Antwort. Dass ein Sprachmodell auch Bilder und PDFs klassifiziert und Begründungen schreibt, Jev aber nur Text versteht, steht in der Tabelle als Fähigkeit, nicht als Punktwert. Ein Vergleich von Äpfeln mit Birnen bleibt es trotzdem.
So haben die Modelle gefragt und geantwortet
Jedes System hat seine eigene Schnittstelle. Alle bekamen denselben Text und dieselben Kategorienbeschreibungen, aber in ihrer jeweiligen Form. Jev bekommt den Text als Zustand und eine Choice-Frage mit den Kategorien als Kriterien:
{
  "state": "Bridge3D: Enabling Vision-Language-Action Models to See and Act in 3D ...",
  "questions": {
    "q": {
      "type": "choice",
      "instructions": "Which arXiv category is the primary category of this computer science paper?",
      "criteria": {
        "cs.CL": "Computation and Language: natural language processing, ...",
        "cs.RO": "Robotics: robot control, manipulation, locomotion, ..."
      }
    }
  }
}
Zurück kommen die Wahl, eine Sicherheit und eine Wahrscheinlichkeit pro Kategorie, zum Beispiel "choice": "cs.RO", "confidence": 1.
Die Sprachmodelle bekommen dieselbe Frage und dieselben Kategorien als Systemanweisung, den Text als Nachricht und über Structured Outputs ein festes Antwortschema. Das Feld label darf nur eine der acht Kategorien enthalten:
{
  "label": {
    "type": "string",
    "enum": ["cs.CL", "cs.CV", "cs.CR", "cs.RO", "cs.DB", "cs.SE", "cs.HC", "cs.DC"]
  },
  "confidence": { "type": "number" }
}
Die Antwort sieht dann so aus: {"label": "cs.RO", "confidence": 0.99}. Die Sicherheit ist dabei eine Zahl, die das Modell selbst hinschreibt, keine Wahrscheinlichkeit aus seinem Inneren. Die Anbieter geben diese über OpenRouter nicht heraus.
Das NLI-Modell prüft für jede Kategorie, ob aus dem Text der Satz „This text is about Robotics: robot control, manipulation, …“ folgt, und vergleicht die Werte. GLiNER, Laya und die anderen Decision-Modelle nutzen jeweils die Bibliothek ihres Herstellers und liefern Werte pro Kategorie.
Gegen kleine und mittlere Sprachmodelle ist kein Unterschied messbar
Auf den 400 arXiv-Papern trifft Jev in 86,3 Prozent der Fälle die Kategorie der Autoren. GPT-6 Luna kommt auf 88,8 Prozent, Gemini 3.5 Flash-Lite auf 88,0, Claude Haiku 4.5 auf 87,3 und Claude Sonnet 5 auf 89,8 Prozent. Alle vier Sprachmodelle liegen damit im Punktwert leicht vor Jev. Nach Korrektur für multiples Testen ist keiner dieser Unterschiede bei 400 Fällen statistisch belastbar. Das heißt nicht, dass die Systeme gleich gut sind. Es heißt, dass dieser Test sie nicht auseinanderhalten kann.
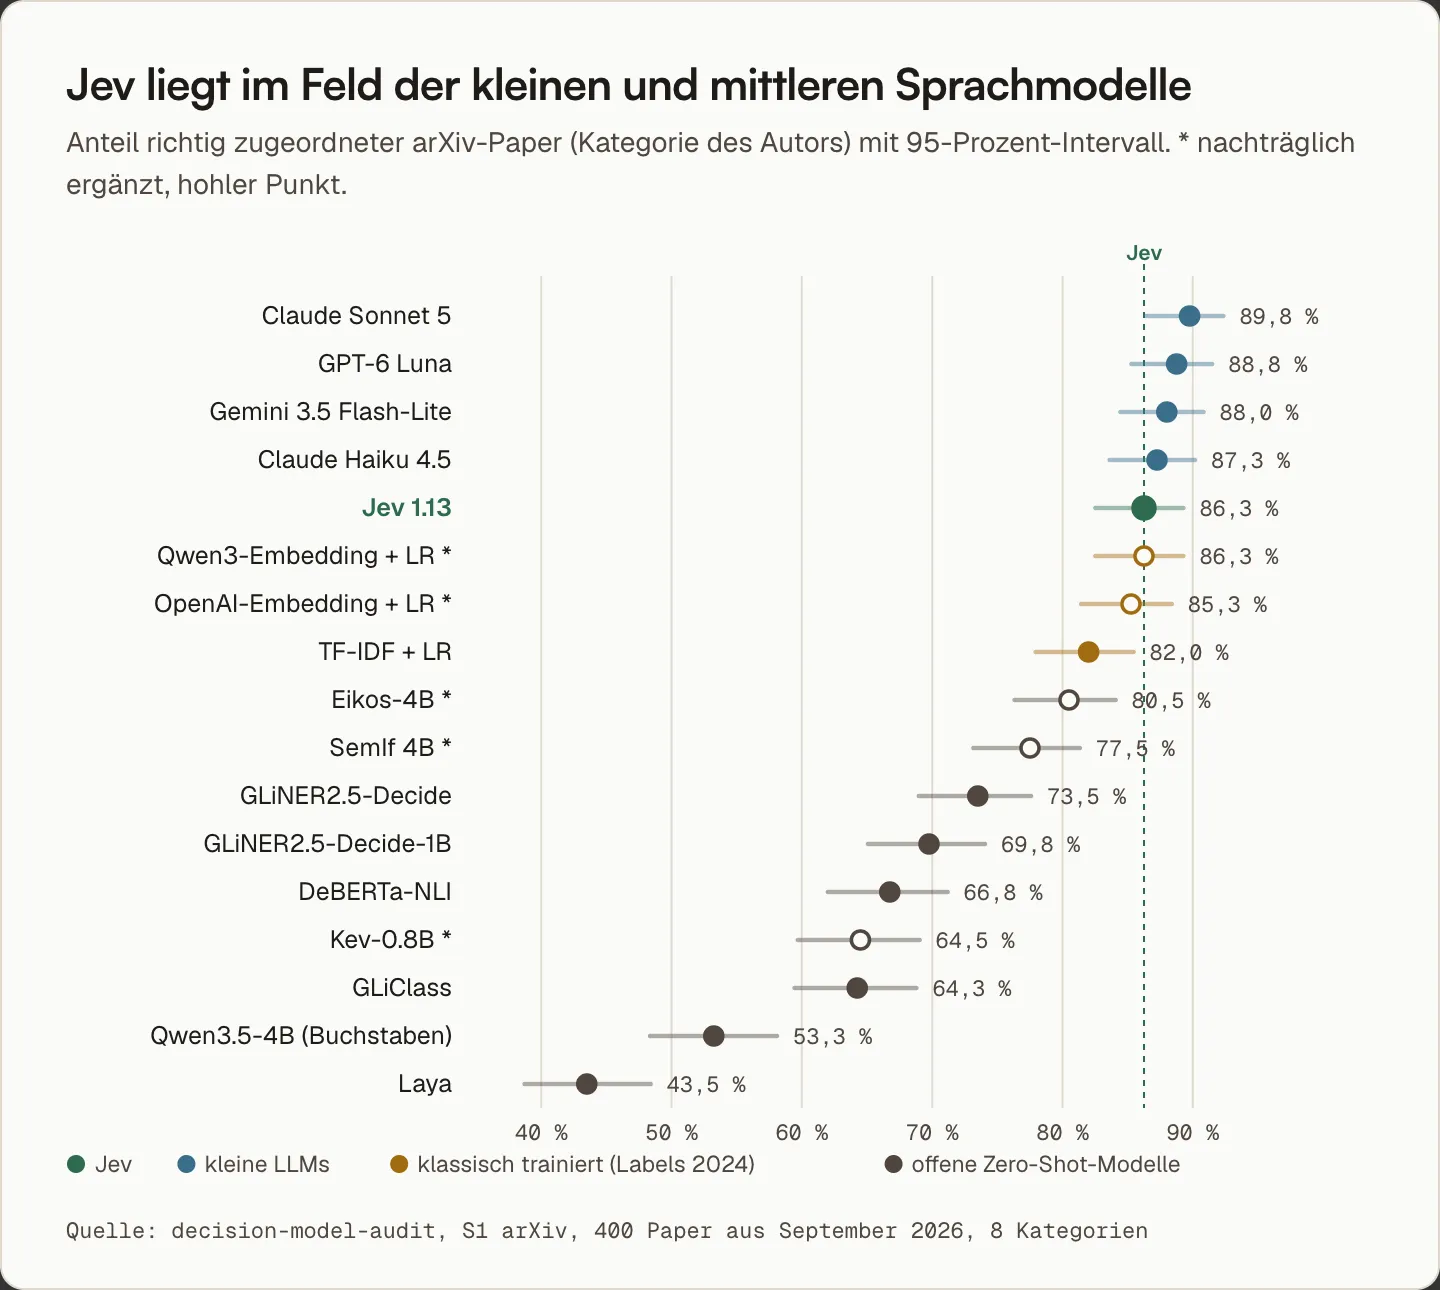
Ein Grund dafür liegt in der Aufgabe selbst. Sie ist für heutige Sprachmodelle vermutlich zu einfach, und die besten Systeme liegen nah an dem, was die Labels überhaupt hergeben. Alle fünf API-Modelle liegen gemeinsam nur bei 18 Papern falsch, also bei 4,5 Prozent, und bei 16 davon einigen sie sich auf dieselbe andere Kategorie. Zwischen gut und sehr gut bleibt wenig Platz. Eine schwerere Aufgabe könnte die Systeme stärker trennen. Bei den Federal-Register-Dokumenten war die Decke noch näher: Jev und alle vier Sprachmodelle lagen zwischen 99,2 und 99,7 Prozent, ohne messbaren Unterschied. Die offenen Modelle kamen dort auf 81 bis 98 Prozent.
Wie wenig ein einzelner Lauf dabei aussagt, zeigt eine Wiederholung. Ich habe 98 Paper ein zweites Mal an dieselben Modelle geschickt. Jev und Haiku antworteten in 99 Prozent der Fälle identisch. GPT-6 Luna änderte bei jedem zwanzigsten Paper seine Meinung. Seine Trefferquote bei diesen Fällen fiel dabei von 89,8 auf 85,7 Prozent. Zumindest bei GPT-6 Luna liegen Unterschiede von wenigen Punkten also im Bereich dessen, was ein zweiter Lauf von allein verschiebt.
Beim Preis liegt Jev vorn. Über OpenRouter kosteten 1.000 Entscheidungen bei Jev 0,035 US-Dollar, bei GPT-6 Luna 0,065, bei Gemini 0,21, bei Haiku 0,89 und bei Sonnet 2,48 US-Dollar. Die Antwort kam bei Jev im Median nach 0,47 Sekunden, bei den Sprachmodellen nach 0,77 bis 2,14 Sekunden, bei GPT-6 Luna nach 1,14 Sekunden. Jev war also rund 2,4-mal so schnell wie GPT-6 Luna und 1,9-mal so günstig. Schickt man zehn Paper in einer Anfrage, sinken die Kosten bei Jev und GPT-6 Luna um etwa ein Viertel. Pro Entscheidung ist Jev dann rund 3,3-mal schneller und 1,8-mal billiger als GPT-6 Luna.
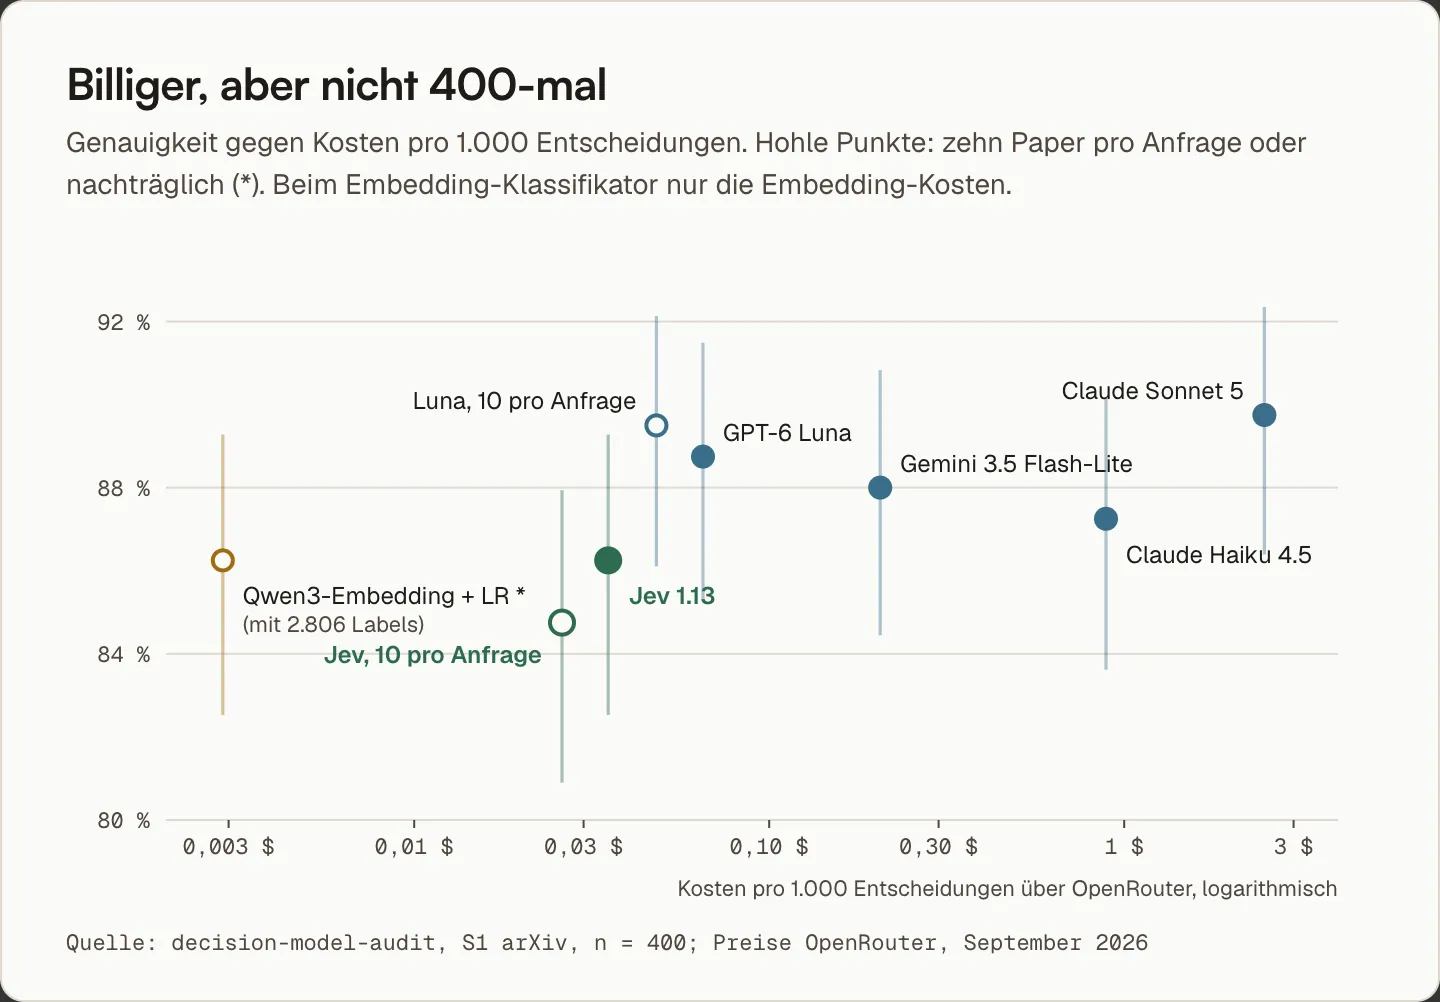
Das ist ein echter Vorteil, aber kein Faktor 400. TypeSafes Faktoren stammen aus eigenen Workflow-Tests, in denen Jev gegen eine Reihe von Sprachmodellen antritt, von Claude Haiku 4.5 bis Claude Opus 5. GPT-6 Astra und Claude Fable 5.1 lieferten dort nur die Referenzantworten. Aus den veröffentlichten Tabellen lassen sich die beiden Faktoren nicht direkt nachrechnen, die Größenordnung passt aber zu den teuersten Modellen im Vergleich wie Opus 5. Gegen ein solches Modell ist vieles 200-mal schneller. Aufschlussreicher ist GPT-6 Luna in TypeSafes eigener Tabelle: Dort ist Jev etwa 8-mal günstiger und rund 30-mal schneller, vermutlich weil jede Entscheidung in diesen Workflows aus vielen Einzelfragen besteht. In meinem Test mit einer Frage pro Paper sind es 1,9 und 2,4. Wer ohnehin mit einem kleinen Modell entscheidet, gewinnt also eher einen Faktor zwei bis drei. (TypeSafe Workflow Evals, TypeSafe)
Wo Jev tatsächlich heraussticht, ist die Stabilität. Kehrt man die Reihenfolge der Kategorien um oder beschreibt sie anders, bleiben 97,5 bis 99 Prozent seiner Antworten gleich. Bei GPT-6 Luna sind es 94 bis 95, bei Gemini 92 bis 93 Prozent. Für ein System, das im Hintergrund dieselbe Entscheidung tausendfach treffen soll, ist das eine Eigenschaft, die sich im Betrieb bemerkbar macht.
Eine unabhängige Replikation mit anderen Fragetypen
Fast zeitgleich hat Stefan Rossmeier einen eigenen Vergleich von Jev und GPT-6 Luna veröffentlicht, mit einem ganz anderen Aufbau: 5.760 synthetische Entscheidungen aus 16 Unternehmensbereichen, gleichmäßig verteilt auf Choice, Noul und Score, mit Labels aus festen Regeln. Dort liegt Jev insgesamt 1,4 Punkte vor GPT-6 Luna, bei Choice liegen beide praktisch gleichauf. Jevs Vorsprung kommt vor allem aus den Noul-Fragen. GPT-6 Luna sagt dort auffällig oft nein und übersieht deshalb rund jeden vierten Fall, in dem die richtige Antwort ja wäre. Jev ist in beide Richtungen ausgeglichen. Bei Score treffen alle Systeme nur rund 40 Prozent der Stufen exakt, und Jevs Kalibrierung ist dort mit einem Fehler von 0,31 deutlich schlechter als bei Choice. Auch Rossmeier misst Jev etwa dreimal so schnell und rund 1,7-mal so günstig wie GPT-6 Luna. (decision-model-evals)
Ein Detail relativiert die Zahl 5.760: Die Fälle entstehen aus 160 Grundszenarien, die jeweils mit zwölf festen Kontextsätzen kombiniert werden. Wertet man pro Szenario aus statt pro Fall, liegt das 95-Prozent-Intervall für Jevs Vorsprung bei minus 0,3 bis plus 3,0 Punkten. Diese Nachrechnung stammt von mir, auf Basis seiner veröffentlichten Rohdaten. Beide Tests kommen damit zum selben Schluss aus entgegengesetzten Richtungen: Zwischen Jev und einem kleinen Sprachmodell ist bei der Genauigkeit kein belastbarer Unterschied messbar, bei Preis und Tempo schon.
In der Praxis: Wenn Sie heute schon ein kleines Sprachmodell mit Structured Outputs für einfache Klassifikation einsetzen, gewinnen Sie mit Jev keine verlässlich höhere Genauigkeit, sondern Preis, Tempo und Konstanz. Bei Ja-Nein-Fragen lohnt ein Blick darauf, ob Ihr Sprachmodell eine Seite bevorzugt. Ob sich ein zusätzlicher Anbieter lohnt, hängt an Ihrem Volumen. Bei einer Million Entscheidungen pro Monat geht es in meinem Test um rund 30 US-Dollar Unterschied gegenüber GPT-6 Luna.
Die offenen Alternativen bleiben deutlich zurück
Gegen die offenen Modelle, die ich auf einem Laptop mit 16 GB Arbeitsspeicher testen konnte, liegt Jev klar vorn. GLiNER2.5-Decide, Fastinos direkte Antwort auf Jev, trifft 73,5 Prozent, also 12,8 Punkte weniger. Das NLI-Modell von Moritz Laurer, ein klassischer Zero-Shot-Klassifikator aus der Zeit vor Jev, kommt auf 66,8 Prozent, GLiClass auf 64,3 und Laya auf 43,5 Prozent. Nachträglich getestet habe ich noch Eikos-4B mit 80,5 und SemIf mit 77,5 Prozent. Alle diese Abstände sind statistisch belastbar.
Das steht scheinbar im Widerspruch zum Vergleich von LangWatch mit der Überschrift „Open models caught up with Jev“. Dort liegen offene Modelle mit bis zu 28 Milliarden Parametern bei acht von elf Aufgaben gleichauf. Die beiden Ergebnisse schließen sich nicht aus. LangWatch misst auf öffentlichen Datensätzen, die Modelle im Training gesehen haben können, und die großen Modelle mit 26 bis 27 Milliarden Parametern konnte ich auf dem Laptop nicht testen. Für Modelle, die auf dem Laptop laufen, hält die Aussage auf frischen Daten aber nicht. (LangWatch)
Wie stark das Ergebnis dabei von der Art der Abfrage abhängt, zeigt ein Nebenbefund. Qwen3.5-4B ist ein kleines offenes Sprachmodell, das ich auf dem Laptop ohne Structured Outputs befragt habe. Statt es eine Antwort schreiben zu lassen, habe ich die Kategorien als Buchstaben aufgelistet und direkt abgelesen, mit welcher Wahrscheinlichkeit das Modell als Nächstes A, B, C und so weiter schreiben würde:
Which arXiv category is the primary category of this computer science paper?

Options:
A) cs.CL: Computation and Language: natural language processing, ...
B) cs.CV: Computer Vision and Pattern Recognition: ...
...
H) cs.DC: Distributed, Parallel, and Cluster Computing: ...

Answer with the letter of the correct option only.
So kam es auf 53,3 Prozent, vor allem weil es auffällig oft A wählte, egal was im Text stand. SemIf verwendet dasselbe Modell, fragt aber mit dem Prompt und der Auslesemethode seines Entwicklers und kommt auf 77,5 Prozent. Dasselbe Modell, 24 Punkte Unterschied, allein durch Prompt und Auslesemethode.
In der Praxis: Ein offenes Modell auf eigener Hardware ist für Datenschutz und Kosten attraktiv, aber die Zahlen aus Launch-Posts und Leaderboards übertragen sich nicht automatisch auf Ihre Daten. Testen Sie jedes Modell mit Ihrer eigenen Abfrage auf eigenen Beispielen, bevor Sie sich festlegen.
Was Jevs Wahrscheinlichkeiten taugen
Das eigentliche Versprechen von Jev sind nicht die Antworten, sondern die Wahrscheinlichkeiten dazu. Sie sollen es erlauben, sichere Fälle automatisch zu entscheiden und unsichere an einen Menschen zu geben.
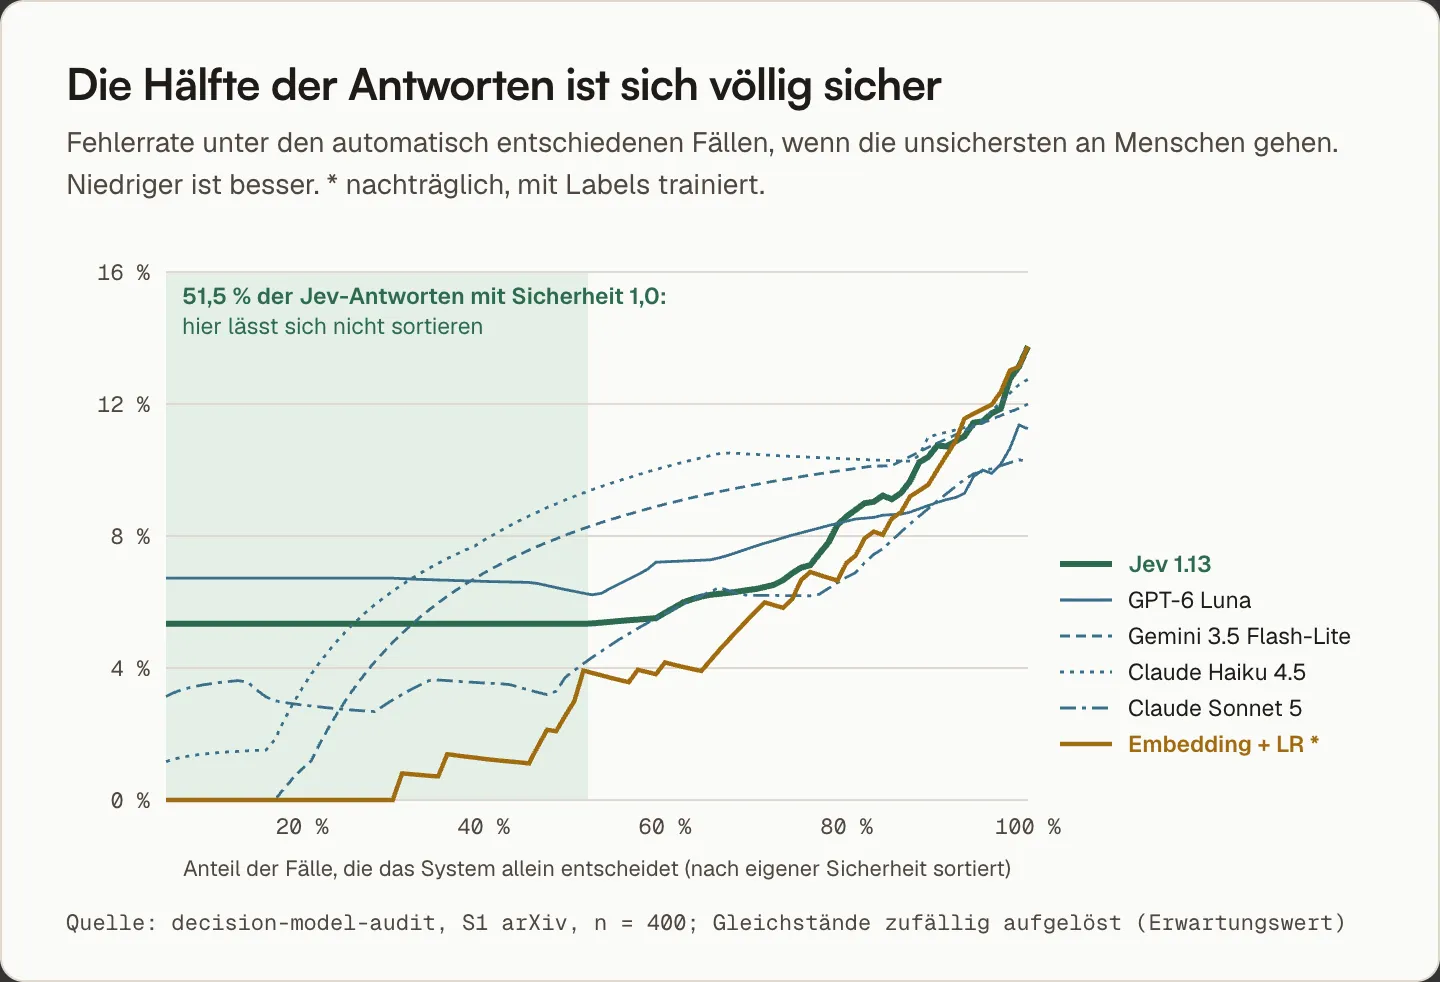
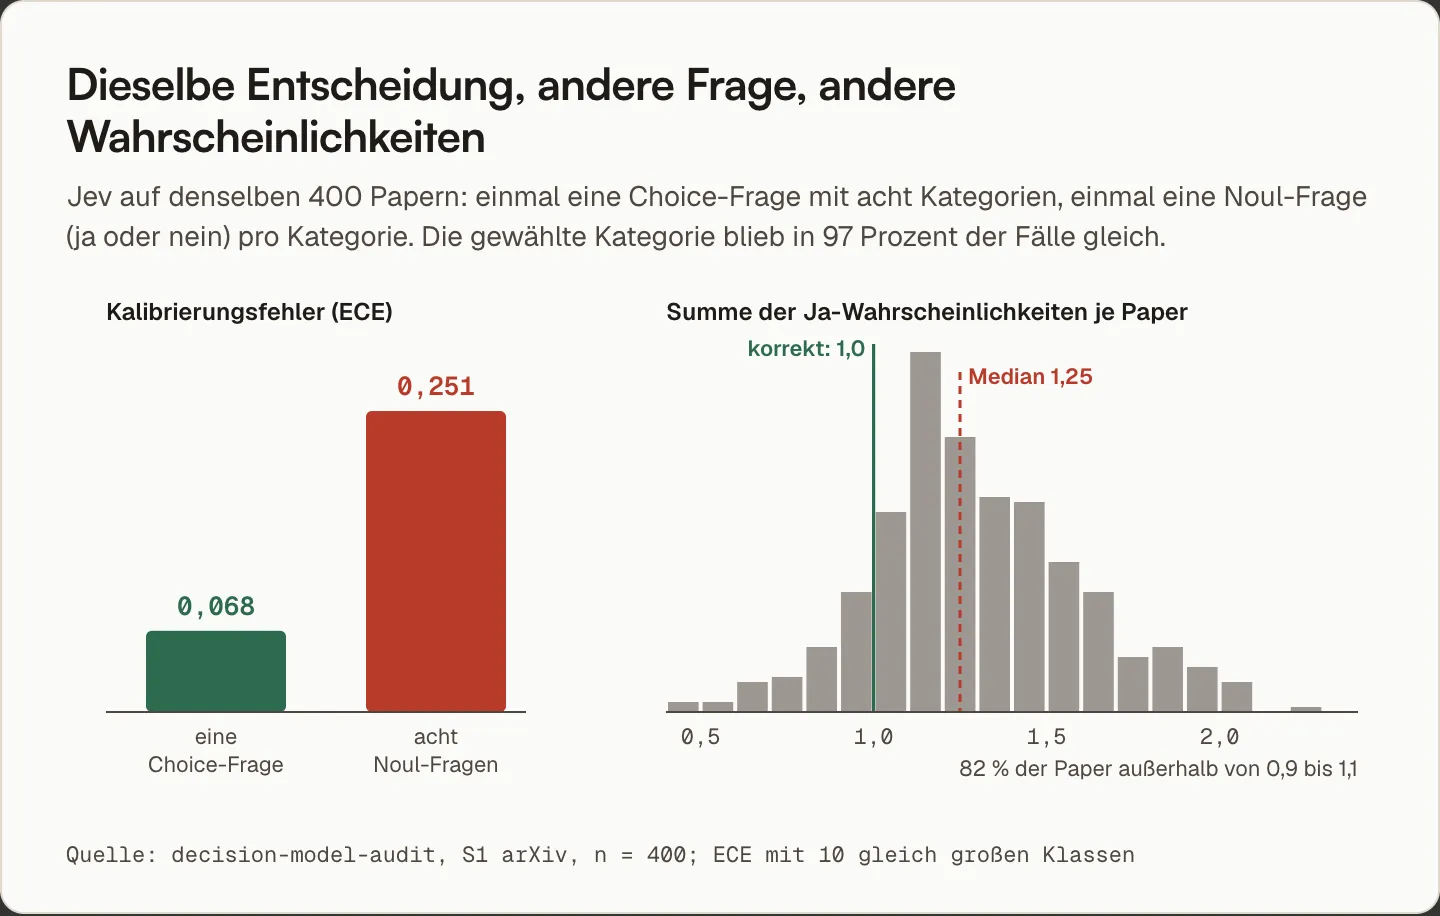
Im Mittel sind sie ordentlich kalibriert. Der erwartete Kalibrierungsfehler (ECE) fasst zusammen, wie weit die angegebene Sicherheit im Durchschnitt von der tatsächlichen Trefferquote abweicht. Null wäre perfekt. Jev liegt bei 0,068, also im Schnitt knapp sieben Prozentpunkte daneben, und damit auf dem Niveau der Sprachmodelle. Das Problem steckt in der Verteilung. Bei 51,5 Prozent aller Antworten gibt Jev eine Sicherheit von exakt 1,0 an. Innerhalb dieser Hälfte lässt sich nicht mehr sortieren, welche Fälle ein Mensch zuerst prüfen sollte. Rossmeier kommt auf seinen Daten auf 48,7 Prozent, das Muster ist also kein Zufall meiner Stichprobe.
Deutlicher wird es, wenn man dieselbe Frage anders stellt. Statt einer Choice-Frage mit acht Kategorien habe ich Jev acht Noul-Fragen gestellt, eine pro Kategorie: „Ist die richtige Kategorie cs.RO?“ Die gewählte Kategorie blieb fast immer dieselbe. Der Kalibrierungsfehler stieg aber von 0,068 auf 0,251.
Dazu kommt ein zweiter Befund. Acht getrennte Ja-Nein-Fragen sind wie acht getrennte Klassifikatoren, ähnlich wie acht einzelne logistische Regressionen. Für einen einzelnen Fall müssen sich ihre Ja-Wahrscheinlichkeiten nicht exakt zu 1 addieren. Weil aber jedes Paper genau eine Hauptkategorie hat, müssten gut kalibrierte Antworten im Durchschnitt auf 1 kommen. Bei Jev lag die Summe im Median bei 1,25, und bei 82 Prozent der Paper lag sie außerhalb von 0,9 bis 1,1. Jev sagt bei diesen Ja-Nein-Fragen also systematisch zu oft ja. Die Wahrscheinlichkeiten addieren sich im Mittel auf 125 Prozent. Das kennt man sonst aus Motivationsvorträgen. Ein unabhängiges Audit eines Forschers der UCLA fand mit einem anderen Datensatz dasselbe Muster. (Zenodo, alexmolas.com)
Einen anderen Kritikpunkt konnte ich dagegen nicht bestätigen. Nach alexmolas.com gab Jev für den Wurf einer fairen Münze eine Wahrscheinlichkeit von 0,92 an. Bei Noul-Fragen mit ausdrücklich genannter Wahrscheinlichkeit, etwa der Urne mit sieben roten und drei blauen Kugeln, lag Jev im Mittel nur 0,027 daneben. Und bei der Frage, ob überhaupt eine Kategorie passt, ist Jev stark. Mit einer ausdrücklichen Option „keine davon“ erkannte es bei 100 Papern aus Physik, Mathematik, Biologie und Ökonomie in 95 Fällen, dass nichts passt, und sagte bei den passenden Informatik-Papern nur in einem Prozent fälschlich „keine“. Ohne diese Option ist jede Antwort zwangsläufig falsch. Dann gab Jev 11 Prozent seiner Antworten eine Sicherheit von mindestens 0,9, GPT-6 Luna dagegen 53 Prozent.
In der Praxis: Nutzen Sie Jevs Wahrscheinlichkeiten zum Sortieren, nicht als absolute Wahrheit. Stellen Sie eine Frage mit mehreren Kategorien als Choice und nicht als Serie von Noul-Fragen, und bieten Sie eine Option „keine davon“ an. Bei Score-Fragen ist nach Rossmeiers Daten besondere Vorsicht geboten. Bevor Sie einen Schwellenwert festlegen, prüfen Sie auf einigen hundert eigenen Fällen, wie viele Fehler oberhalb dieser Schwelle tatsächlich passieren, und kalibrieren Sie bei Bedarf nach.
Mit Labels holt ein einfacher Klassifikator auf
Bis hierher war die Vergleichsgruppe klar: Zero-Shot gegen Zero-Shot. Die interessantere Frage ist, was passiert, wenn Sie Beispiele haben. Dafür habe ich nachträglich ein bekanntes Rezept aus dem Supervised Learning getestet. Jeder Text wird mit einem Embedding-Modell in einen Vektor übersetzt, und darauf lernt eine logistische Regression die Kategorien. Als Trainingsdaten dienten 2.806 arXiv-Abstracts aus dem Jahr 2024, getestet wurde auf denselben 400 Papern aus dem September 2026. Zwischen Training und Test liegen also fast zwei Jahre.
Mit allen 2.806 Beispielen kommt Qwen3-Embedding-8B mit logistischer Regression auf 86,3 Prozent, denselben Wert wie Jev. Der Kalibrierungsfehler liegt bei 0,029 statt 0,068, die Übergabe unsicherer Fälle an Menschen funktioniert im Punktwert von allen Systemen am besten, und die Embeddings kosten über OpenRouter etwa ein Zwölftel dessen, was Jev pro Entscheidung kostet. Das Embedding-Modell ist offen und ließe sich auch lokal betreiben. Die Unterschiede in der Genauigkeit sind nicht belastbar, für die Kalibrierung habe ich keinen eigenen Test gerechnet. Ein TF-IDF-Modell, dessen Gewichtung aus den Siebzigerjahren stammt, kommt mit denselben Trainingsdaten auf 82 bis 83 Prozent.
Entscheidend ist, wie viele Beispiele es braucht.
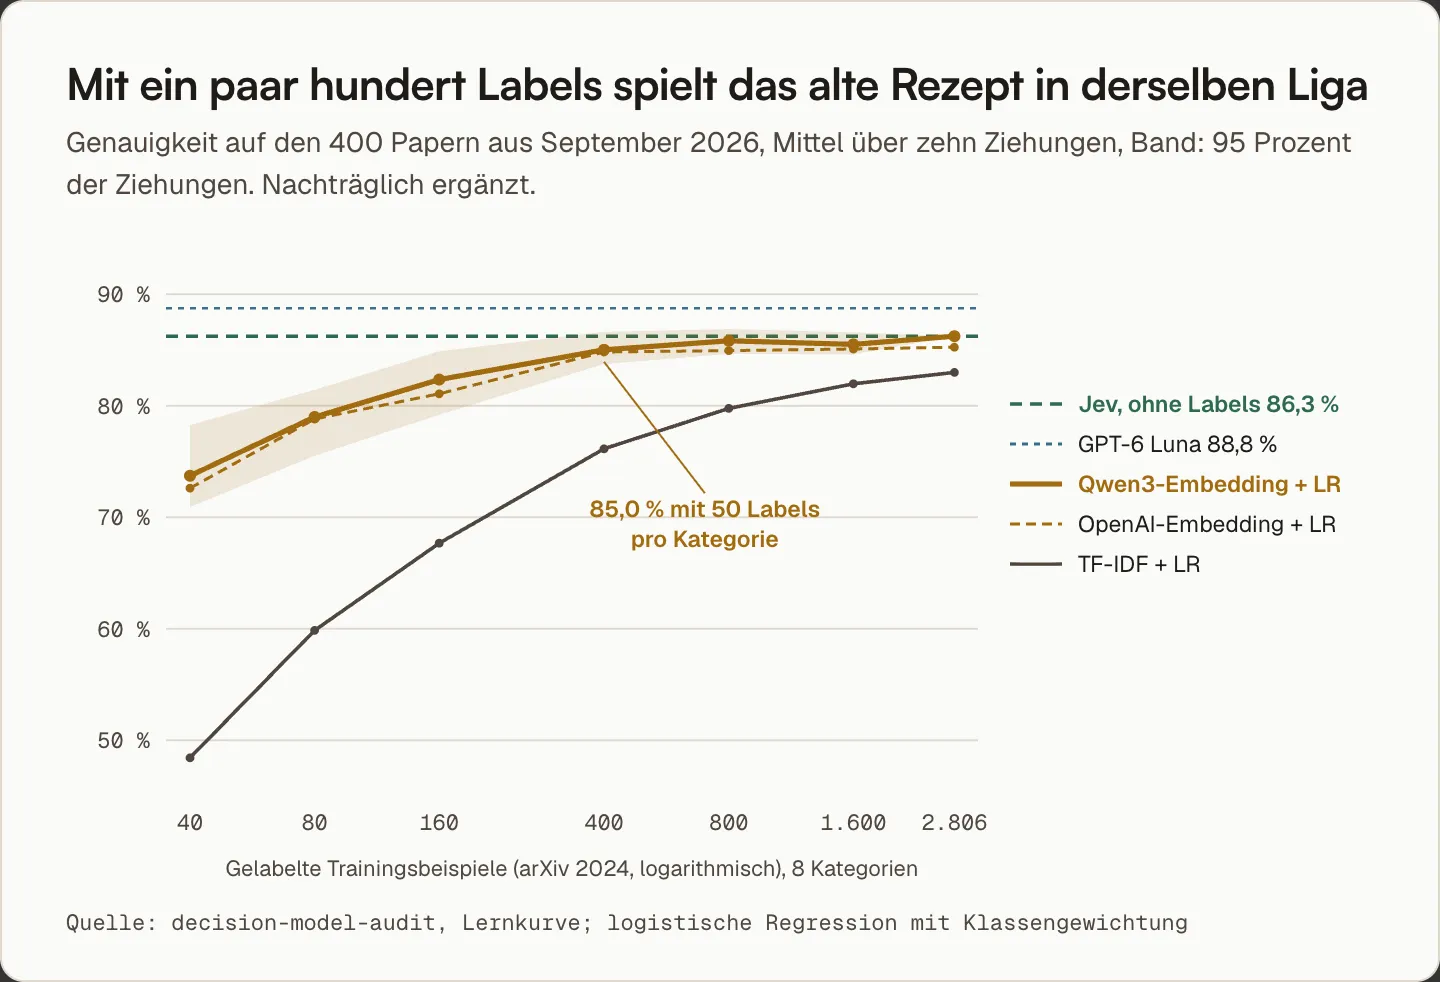
Mit 20 Beispielen pro Kategorie, also 160 insgesamt, erreicht der Embedding-Klassifikator im Mittel über zehn Ziehungen 82,4 Prozent. Mit 50 pro Kategorie sind es 85,0 Prozent, 1,3 Punkte unter Jev, und bei der Übergabe an Menschen liegt er da schon vorn. TF-IDF braucht für dieselbe Genauigkeit etwa zehnmal so viele Beispiele. Den Unterschied machen die modernen Embeddings.
Fairerweise gehören zwei Einschränkungen dazu. Meine Labels gab es geschenkt, weil arXiv sie mitliefert. In einem echten Projekt müssen Sie sie sammeln, prüfen und pflegen, und diese Kosten habe ich nicht gemessen. Und die Lernkurve ist nachträglich entstanden, auf einer einzigen Choice-Aufgabe mit acht Kategorien.
Ein Hinweis in dieselbe Richtung kommt von TextCortex. Deren Modell Raya ist ein Laya-Modell, sechs Minuten lang auf eine einzige Routing-Aufgabe nachtrainiert. Nach Herstellerangaben liegt es bei dieser Aufgabe 3 bis 4 Punkte hinter Jev und bei einer anderen Frageform knapp 10 Punkte davor. (Raya)
Jevs stärkster Fall ist also der Kaltstart: eine Entscheidung, für die es noch keine passenden Labels gibt. Sobald ein paar hundert Beispiele existieren, spielt ein Rezept, das in keiner Launch-Ankündigung vorkommt, in derselben Liga.
In der Praxis: Suchen Sie, bevor Sie ein Zero-Shot-Modell einkaufen, nach Labels, die es schon gibt: Ticketkategorien, Freigaben, Weiterleitungen, Metadaten. Oft reichen einige hundert davon für einen eigenen Klassifikator, der billiger, besser kalibriert und unabhängig von einem Anbieter ist. Jev eignet sich dann als Startpunkt, bis diese Daten vorliegen.
Begründungen und lange Texte
Was Jev grundsätzlich nicht kann, ist eine Entscheidung zu begründen. Ein Sprachmodell kann neben dem Label einen Text ausgeben, mit dem ein Mensch die Entscheidung prüfen oder anfechten kann. GPT-6 Luna und Gemini zitierten dabei in über 90 Prozent der Fälle wörtlich aus dem Paper, Haiku tat das nur selten. Für Entscheidungen, die jemand nachvollziehen muss, ist das ein echter Unterschied.
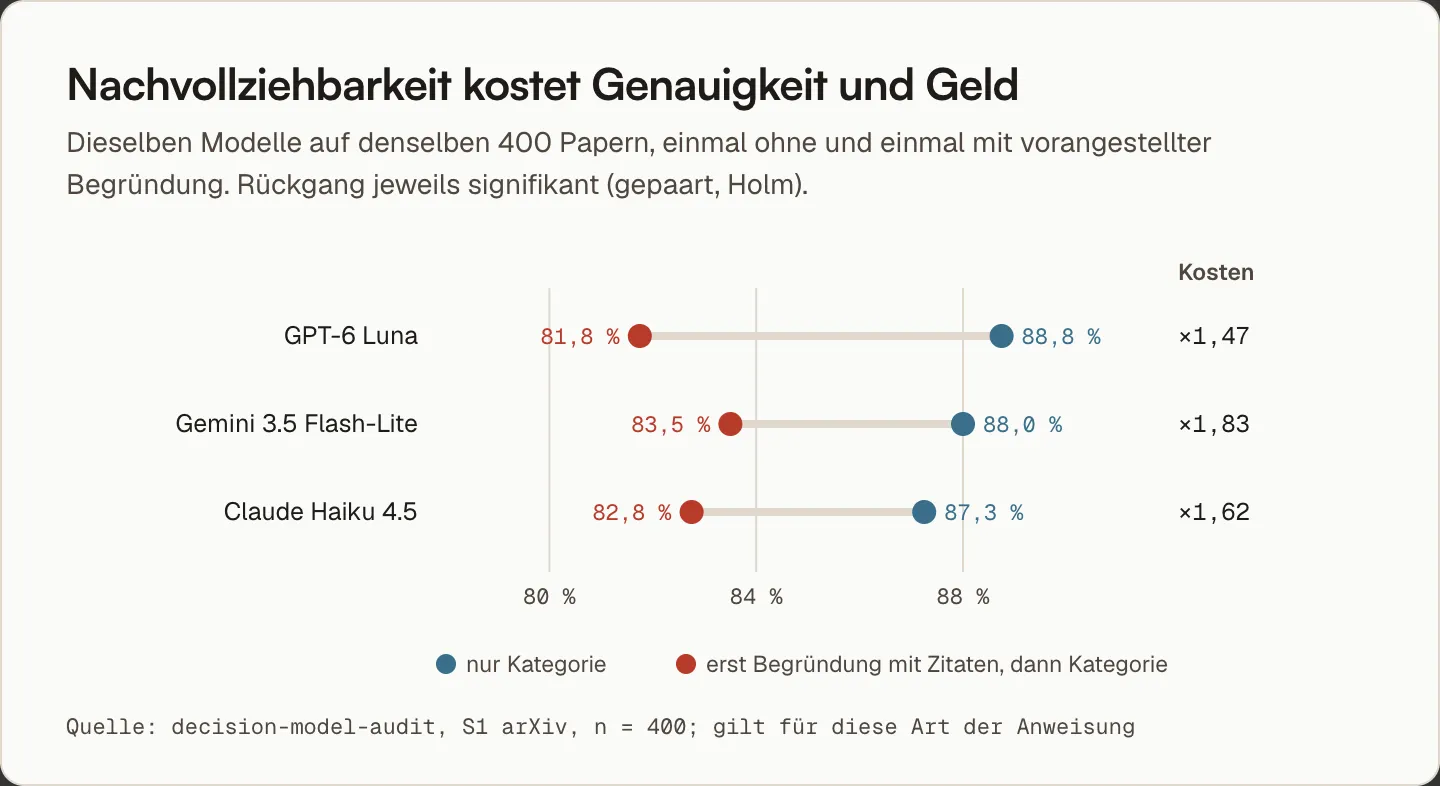
Umsonst ist die Begründung nicht. Als ich die Sprachmodelle anwies, zuerst eine Begründung mit Zitaten zu schreiben und danach die Kategorie zu wählen, sank ihre Trefferquote um 4,5 bis 7 Punkte. Die Kosten stiegen auf das 1,5- bis 1,8-Fache. Das gilt für genau diese Art der Anweisung, nicht für Begründungen im Allgemeinen, und ob die Begründungen Menschen tatsächlich beim Prüfen helfen, habe ich nicht gemessen. Eine flüssige Begründung für eine falsche Antwort ist leider genauso überzeugend wie eine für eine richtige.
Bei langen Texten trennt sich das Feld ebenfalls. In einem Noul-Test stand der entscheidende Satz, eine Kündigung, irgendwo in bis zu 24.000 Tokens Verwaltungstext. Jev und GPT-6 Luna fanden ihn bei jeder Länge. Die Encoder mit festem Fenster, also Laya, das NLI-Modell und GLiClass, lasen nur den Anfang und fielen bei langen Texten auf rund 46 bis 50 Prozent, also auf Rateniveau zwischen Ja und Nein. Ohne Zerlegung in Abschnitte reichte für GLiNER der Arbeitsspeicher des Laptops nicht, mit der dokumentierten Zerlegung erreichte es 86 Prozent. Der Satz fiel stilistisch allerdings auf. Das war ein Suchtest, kein Verständnistest für lange Dokumente.
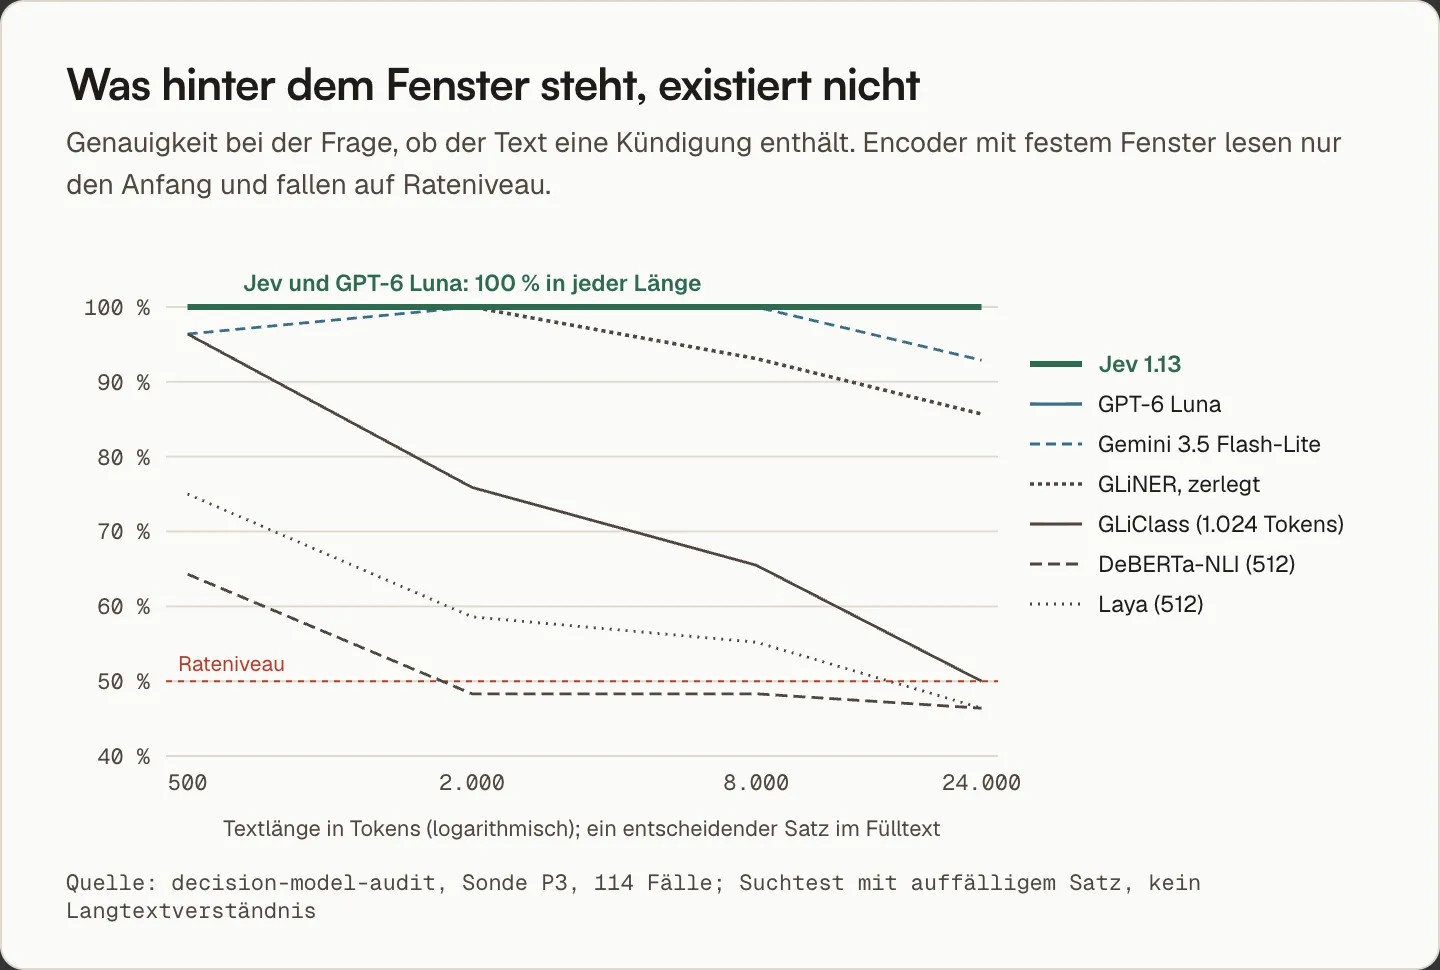
In der Praxis: Wenn jemand eine Entscheidung nachvollziehen oder anfechten können muss, bleibt das Sprachmodell die bessere Wahl. Kalkulieren Sie dafür Genauigkeit und Kosten ein, und lassen Sie die Begründung im Zweifel nach der Entscheidung schreiben statt davor. Bei langen Dokumenten prüfen Sie zuerst, wie viel Text ein Modell überhaupt sieht.
Welches Werkzeug für welche Entscheidung
Aus den Ergebnissen ergeben sich Fragen, die Sie der Reihe nach stellen können.
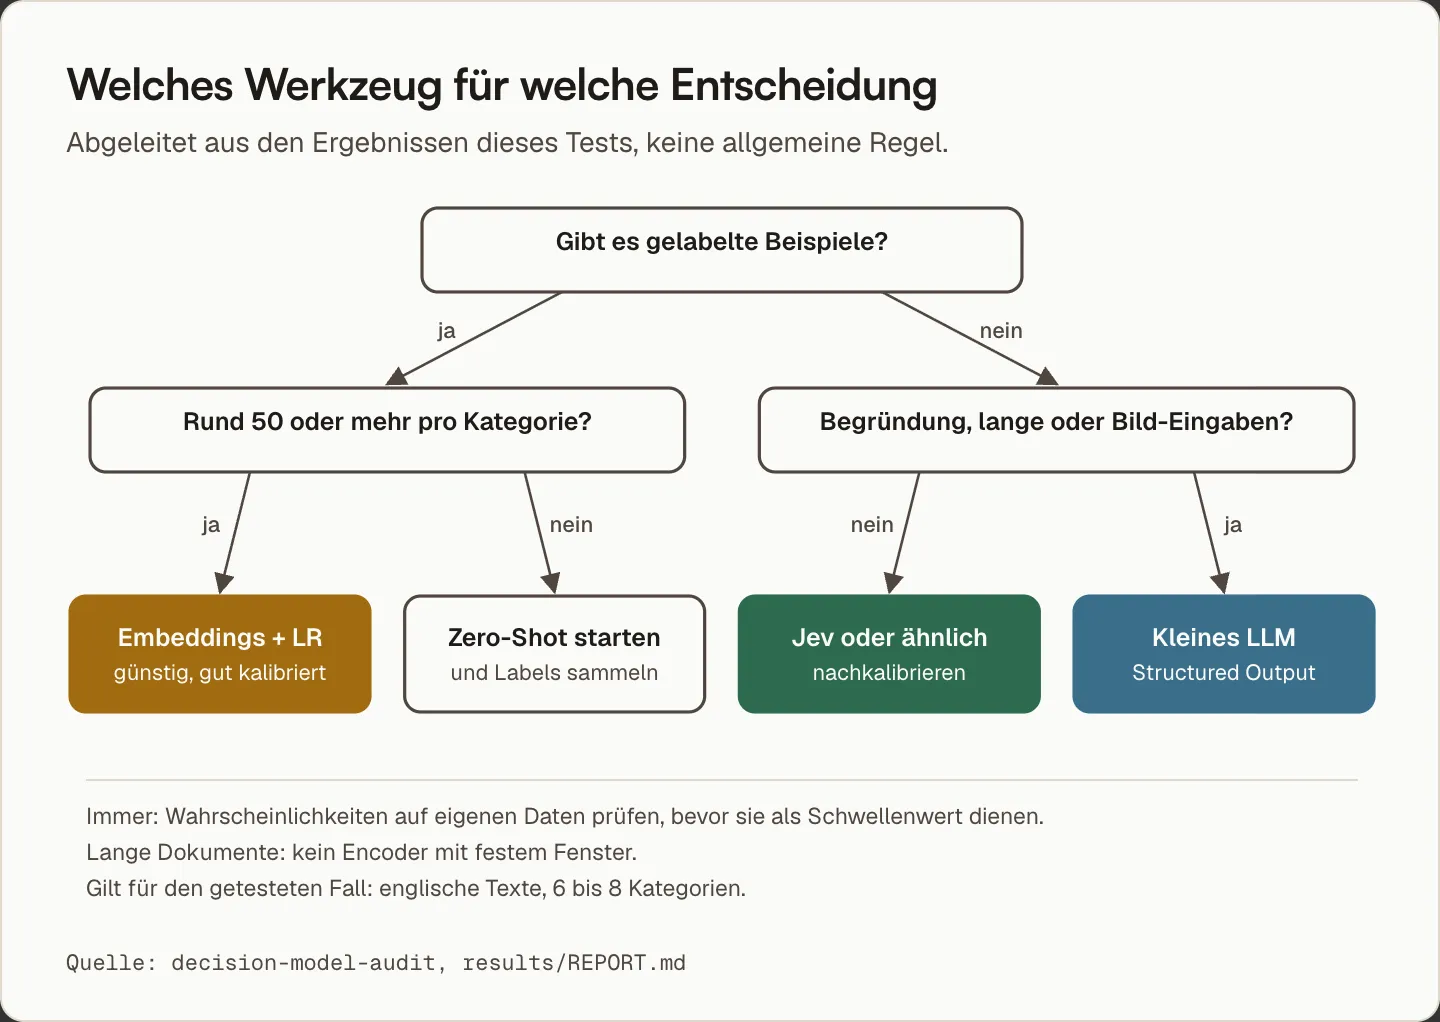
- Prüfen Sie zuerst, ob es schon Labels gibt. Oft stecken sie in Tickets, Freigaben oder Metadaten, die ohnehin jemand gepflegt hat. Mit einigen hundert Beispielen lohnt ein Klassifikator auf Embeddings, bevor Sie ein Zero-Shot-Modell einkaufen.
- Nutzen Sie ein Decision-Modell wie Jev für den Kaltstart. Hohes Volumen, eine feste Frage, keine Beispiele: Hier war Jev in meinem Test schnell, günstig und stabil.
- Kalibrieren Sie die Wahrscheinlichkeiten auf Ihren eigenen Daten nach. Bei Jev hängen sie am Fragetyp, und die Hälfte der Antworten trägt die Sicherheit 1,0. Ohne Prüfung taugen sie nicht als Grundlage für Schwellenwerte.
- Greifen Sie zum Sprachmodell, wenn jemand die Entscheidung nachvollziehen muss. Das gilt auch für lange Eingaben. Für mehrsprachige oder multimodale Eingaben sprechen die Fähigkeiten der Sprachmodelle, getestet habe ich das nicht.
- Meiden Sie Encoder mit festem Fenster für lange Dokumente, wenn Sie den Text nicht in Abschnitte zerlegen. Was hinter dem Fenster steht, existiert für sie nicht.
Was das zeigt und was nicht
Der Test deckt vor allem eine Aufgabenart ab: Choice-Fragen, die englische Texte sechs bis acht Kategorien zuordnen. Noul habe ich nur mit konstruierten Testfällen geprüft, Score gar nicht. Rossmeiers Replikation füllt diese Lücke teilweise, allerdings mit synthetischen Daten und Labels aus festen Regeln. Entscheidungen mit Ausnahmen oder Rechenschritten habe ich nicht geprüft, ebenso wenig andere Sprachen oder Aufgaben mit sehr vielen Optionen, bei denen Jev nach Angaben der Laya-Entwickler stärker ist. Das Ganze ist eine Momentaufnahme vom September 2026. Modelle hinter einer API können sich jederzeit ändern.
Die Labels der arXiv-Paper habe ich nicht nachgeprüft, und die konstruierten Testfälle sind künstlich. Lokale Modelle waren durch 16 GB Arbeitsspeicher begrenzt, die großen offenen Modelle fehlen deshalb. Bis auf die Wiederholung mit 98 Papern lief jede Bedingung einmal. Tempo und Kosten habe ich einzeln nacheinander gemessen, nicht unter paralleler Last. Viele Analysen, darunter die Embedding-Baselines und die Lernkurve, habe ich erst nach den ersten Ergebnissen ergänzt, sie sind im Repository entsprechend markiert.
Wie dieser Text entstanden ist
Recherche, Experimente, Auswertung und dieser Entwurf sind in rund zwei Tagen entstanden, am 27. und 28. September 2026. Die lokalen Modelle liefen dabei über Nacht auf dem Laptop. Die Arbeit haben AI-Agenten in Claude Code erledigt: Claude Opus 5.5 hat geplant, Code geschrieben, die Läufe gesteuert und den Text entworfen, weitere Claude-Agenten haben Quellen recherchiert und gegengeprüft. Als zweites Modell hat Codex mit GPT-6 Sol die Methodik, die Ergebnisse und die Gliederung unabhängig geprüft. Den Vortrag des TypeSafe-Gründers hat Gemini transkribiert. Ich habe die Fragestellung vorgegeben, jede Entscheidung über Daten, Modelle und Budget getroffen, Zwischenergebnisse geprüft und den Text überarbeitet.
Zurück zum neuen Namen
Jev ist kein neues Prinzip. Es ist ein Zero-Shot-Klassifikator mit sauberer Schnittstelle, gutem Preis und bemerkenswert stabilen Antworten. In meinem Test war es bei 400 Fällen nicht von kleinen und mittleren Sprachmodellen zu unterscheiden und schlug die getesteten offenen Alternativen deutlich. Seine Wahrscheinlichkeiten brauchen eine Prüfung auf den eigenen Daten. Und wer schon Labels hat, kommt mit einem bekannten Verfahren und einem aktuellen Embedding-Modell auf fast dasselbe Ergebnis.
Wer Jev als Qualitätssprung liest, verwechselt Preis und Tempo gegenüber den teuersten Modellen mit einem Sprung in der Sache. Das ist schade, denn das Produkt ist für seinen Einsatzzweck gut gemacht.
Wer noch keine Labels hat, bekommt mit Jev einen guten Start. Wer welche hat, sollte zuerst das alte Rezept ausprobieren.
Der vollständige Test, alle Daten, jede Modellantwort und die Auswertung liegen im öffentlichen Begleit-Repository: decision-model-audit. Dort steht auch jede Abweichung vom ursprünglichen Plan, damit Sie die Ergebnisse nachprüfen können, statt mir glauben zu müssen.
Zum Schluss eine Frage an Sie: Wie viele gelabelte Beispiele für Ihre wichtigste Routing-Entscheidung liegen irgendwo in Ihren Systemen, ohne dass jemand sie je als Trainingsdaten betrachtet hat?
Quellen
TypeSafe und Jev: Ankündigung; Dokumentation; Workflow Evals; Vortrag von Diogo Almeida, „I made ChatGPT, now I’m building what’s next“; MarkTechPost; Tom’s Hardware
Unabhängige Prüfungen und Einordnungen von Jev: KDnuggets; decision-model-evals, Stefan Rossmeier; Kalibrierungsaudit, UCLA (Zenodo); alexmolas.com; jev-calibration-audit; LangWatch
Offene Alternativen: GLiNER2.5-Decide; Laya; Raya
Klassifikation, Zero-Shot und Kalibrierung: Spärck Jones 1972, IDF; Chang et al. 2008; Yin et al. 2019; Zaratiana et al. 2023, GLiNER; Guo et al. 2017; OpenAI, GPT-4 Technical Report; OpenAI, Structured Outputs
Datenkontamination: Golchin und Surdeanu 2023
Begleit-Repository: decision-model-audit

Stehen Sie vor einem komplexen Problem? Vor jeder Zeile Code: ein Gespräch. Kein Pitch, keine Verpflichtung.
Gespräch buchen