Brauchen Sie überhaupt ein Decision-Modell?
15 Decision-Modelle im Feldtest auf frischen Daten: wann sich die neue Modellklasse lohnt, wann eine einfache Baseline reicht und was vom Marketing bleibt.
TL;DR. Decision-Modelle sind AI-Modelle, die keinen Text schreiben, sondern zu einer Frage eine von mehreren vorgegebenen Antworten wählen, samt Wahrscheinlichkeit. Seit dem Start von TypeSafes Jev im September 2026 sind zahlreiche erschienen. Ich habe 15 auf frischen Daten getestet.
- Offene Modelle holen auf: Cloudflares Clef, Perplexitys pplx-decider und APUS 9B sind praktisch so genau wie Jev und frei verfügbar.
- Genauigkeit trennt kaum noch: Sechs Modelle sind nicht von Jev zu unterscheiden. Der Preis unterscheidet sich dabei um das bis zu 13-Fache.
- Gleiche Schnittstelle, anderes Verhalten: Nur weil ein Feld „confidence“ heißt, kann man sich noch nicht darauf verlassen. Auch bei langen Texten und vielen Fällen pro Anfrage verhalten sich die Modelle sehr unterschiedlich.
- Wie viel allein entschieden werden kann: Gleich genaue Modelle unterscheiden sich stark darin, wie viele Fälle sie ohne menschliche Prüfung übernehmen könnten. Jev schneidet dabei am schlechtesten ab.
- Mit Labels: Wer schon gelabelte Beispiele hat, fährt mit einer einfachen Baseline aus Embeddings und logistischer Regression am besten. Sie schlug sogar nachtrainierte Decision-Modelle.
- Marketing: Viele Begriffe rund um Jev sind neue Namen für Bekanntes.
Transparenzhinweis: Dieser Text wurde mit AI geschrieben, und die Experimente haben AI-Agenten ausgeführt. Ich habe beides geplant, überwacht und geprüft. Wie das ablief, steht am Ende. Code, Daten und jede Modellantwort liegen im verlinkten Repository.
Am 15. September 2026 stellte das Start-up TypeSafe sein Modell Jev vor, als erstes „System One“-Modell, das entscheidet, statt zu schreiben. Zwei Wochen später gab es zahlreiche Modelle mit derselben Schnittstelle, darunter eines von Cloudflare. Dieser Text prüft 15 davon und beantwortet eine einfache Frage: Brauchen Sie so ein Modell überhaupt?
Was ein Decision-Modell ist und was Teil 1 gezeigt hat
Ein Decision-Modell bekommt einen Text und eine Frage mit festen Antwortmöglichkeiten, etwa: „Welche Abteilung soll dieses Ticket bearbeiten?“ Es wählt eine Antwort und nennt dazu, wie sicher es ist. Fachlich heißt das Zero-Shot-Klassifikation: Das Modell ordnet einen Text einer Kategorie zu, ohne vorher Beispiele dafür gesehen zu haben. Neu ist die Idee nicht, es gibt sie seit 2008.
In Teil 1 habe ich Jev auf frischen Daten getestet: 400 wissenschaftliche Paper aus dem September 2026, die einer von acht Informatik-Kategorien zuzuordnen waren. Die wichtigsten Ergebnisse:
- Gegen kleine Sprachmodelle wie GPT-6 Luna war Jev weder messbar besser noch schlechter, aber günstiger und schneller.
- Gegen offene Modelle, die auf einem Laptop liefen, lag Jev klar vorn. Getestet waren allerdings nur kleine Modelle, die auf 16 GB Arbeitsspeicher passen.
- Jevs Sicherheitsangaben stimmten im Mittel, aber bei der Hälfte der Antworten gab Jev eine Sicherheit von exakt 100 Prozent an. Unter diesen Antworten lässt sich nicht mehr sortieren, welche ein Mensch prüfen sollte.
- Mit Labels, also gelabelten Beispielen, holte eine einfache Baseline auf: Embeddings, das sind Zahlenvektoren, die ein Sprachmodell für einen Text berechnet, plus eine logistische Regression. Mit 400 Beispielen kam sie auf 85 Prozent, Jev ohne Beispiele auf 86.
Das Fazit damals: Wer keine Labels hat, bekommt mit Jev einen guten Start. Wer welche hat, sollte zuerst die Baseline ausprobieren. Teil 2 prüft, ob das nach drei Wochen Entwicklung noch stimmt, mit großen offenen Modellen, auf Deutsch und bei Aufgaben, die Teil 1 nicht abgedeckt hat.
Zwei Wochen nach Jev baut Cloudflare die Schnittstelle nach
Am 30. September veröffentlichte Cloudflare die Modelle Clef und Clef-flash. Sie sprechen dieselbe Schnittstelle wie Jev, lesen neben Text auch Bilder und Videos und stehen als offene Gewichte unter der Apache-2.0-Lizenz auf Hugging Face. Man kann sie über Cloudflares API nutzen oder herunterladen und selbst betreiben. (Cloudflare, Hugging Face)
Ein Start-up gibt der Zero-Shot-Klassifikation einen neuen Namen, und zwei Wochen später bietet einer der größten Infrastrukturanbieter dasselbe offen und multimodal an. Sind Decision-Modelle damit austauschbar geworden?
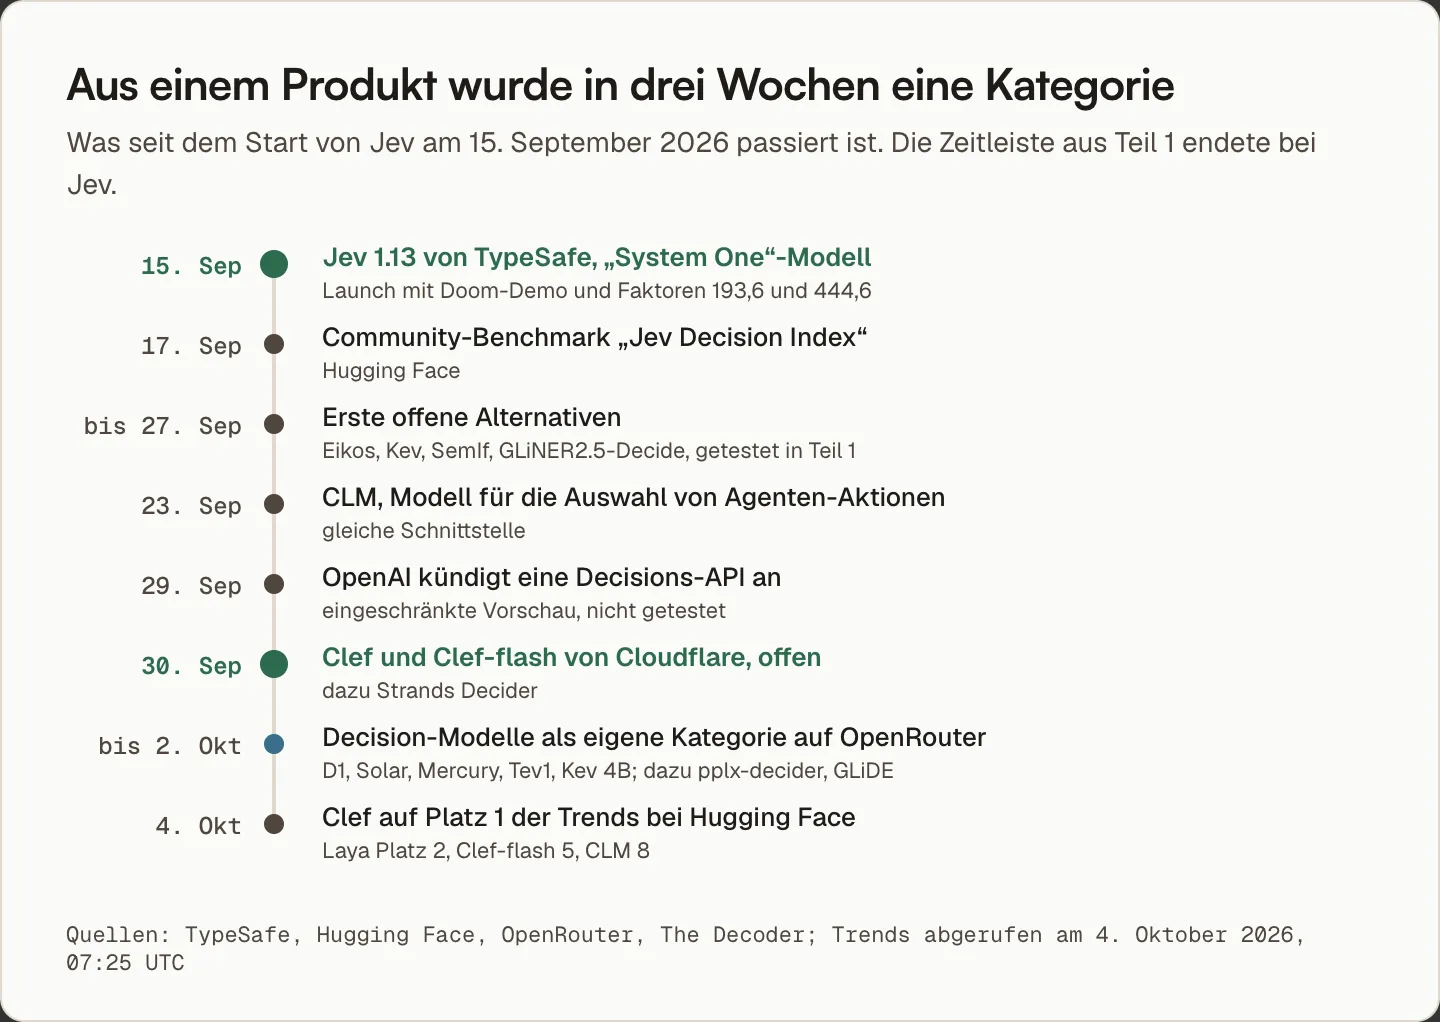
Die Entwicklung war schnell. Zwei Tage nach dem Start pflegte die Community einen eigenen Vergleich, den „Jev Decision Index“. OpenAI kündigte am 29. September eine eigene Decisions-API an, bisher nur als eingeschränkte Vorschau. Anfang Oktober führte der Modellmarktplatz OpenRouter Decision-Modelle als eigene Kategorie. Und am Morgen des 4. Oktober stand Clef auf Platz 1 der Trends bei Hugging Face, der wichtigsten Plattform für offene Modelle. Laya, ein anderes offenes Decision-Modell, stand auf Platz 2, CLM auf Platz 8. Beliebtheit sagt allerdings wenig über die Eignung: Laya und CLM liegen bei meiner Aufgabe unter 45 Prozent. (Decision Index, The Decoder, OpenRouter)
Viel Marketing für einen Zero-Shot-Klassifikator
Teil 1 hat Jev als gut gemachtes Produkt beschrieben, und dabei bleibe ich. Preis, Tempo und Stabilität sind echt, die technische Dokumentation ist bemerkenswert offen, auch über die eigenen Schwächen. Die Begriffe rund um den Start sind dagegen vor allem neue Namen für Bekanntes.
„System One“ verweist auf Daniel Kahnemans schnelles, intuitives Denken, das bei Kahneman aber gerade als fehleranfällig und übermäßig selbstsicher gilt. In der AI-Forschung heißen schnelle Modelle ohne schrittweises Nachdenken schon seit 2019 so. „Noul“ ist eine Ja-Nein-Frage mit Wahrscheinlichkeit, also binäre Klassifikation. „Kann nicht halluzinieren“ heißt nur, dass Jev aus einer festen Liste wählt. Falsch liegen kann es trotzdem, wie dieselbe Website einräumt. Und laut TypeSafes eigener Einführung sollten Antworten mit der Wahrscheinlichkeit 1,0 immer stimmen. In meinem Test trugen 206 von 400 Antworten diesen Wert, 11 davon waren falsch. (TypeSafe, Einführung)
Dazu kamen zum Start 40 Millionen US-Dollar Seed-Finanzierung, angeführt vom Investor DCVC. Für ein Start-up, dessen erstes Produkt technisch ein Zero-Shot-Klassifikator ist, ist das bemerkenswert. Ob die Modelle hinter den Namen austauschbar sind, beantwortet aber weder ein Begriff noch eine Finanzierungsrunde. Das zeigt nur ein Test. (DCVC)
Der Test: dieselben Daten wie in Teil 1, neue Fragen dazu
Alle Modelle bekamen dieselben 400 Paper und dieselben konstruierten Testfälle wie in Teil 1, mit genau derselben Anfrage wie Jev. So lässt sich jede Zahl direkt mit Teil 1 vergleichen.
Getestet habe ich 15 Decision-Modelle von Cloudflare, Perplexity, Fastino, Liquid, Upstage und weiteren Anbietern, über ihre APIs, auf einem Laptop mit 16 GB Arbeitsspeicher oder auf gemieteten Grafikkarten von Nvidia (A40 und A100). Nicht dabei ist OpenAIs Decisions-API, weil sie zum Zeitpunkt des Tests nicht allgemein verfügbar war.
Neu sind vier Aufgaben, die Teil 1 nicht abgedeckt hat:
- Wechselnde Optionen. Zu einer Zusammenfassung eines Papers soll das Modell den richtigen Titel unter fünf ähnlichen finden. Bei jedem Fall sind es andere Titel. Das ist eine Stärke, die Decision-Modelle für sich beanspruchen: Ein klassischer Klassifikator lernt feste Kategorien und kann mit Optionen, die sich von Fall zu Fall ändern, nichts anfangen.
- Behauptung prüfen. Ist ein Satz durch einen Text gedeckt? Mal stammt der Satz aus dem Text, mal aus einem anderen Text, mal ist darin eine einzelne Zahl verändert.
- Zählen. Wie oft steht ein bestimmtes Ereignis, etwa ein fehlgeschlagener Login, in einem Protokoll? Geantwortet wird auf einer Skala von „keinmal“ bis „sechsmal oder öfter“.
- Deutsch. Wie gut kommen die Modelle mit deutschen Texten zurecht? Dafür habe ich 600 Forschungsprojekte des FWF verwendet, des Österreichischen Wissenschaftsfonds. Zu jedem geförderten Projekt gibt es eine Zusammenfassung auf Deutsch und eine auf Englisch. Die Modelle sollten das Forschungsfeld erkennen. (FWF)
Die Regeln sind dieselben wie in Teil 1: Das Protokoll stand vor jedem Lauf fest, alles Nachträgliche ist markiert, und ein zweites Modell hat die Ergebnisse unabhängig nachgerechnet. Alle Aufrufe und die gemieteten Grafikkarten kosteten zusammen rund 11 US-Dollar.
Clef ist so genau wie Jev und frei verfügbar
Clef trifft auf den 400 Papern 85,8 Prozent, Jev 86,3. Ein messbarer Unterschied ist das nicht. Clef-flash, das kleinere Modell, liegt vier Punkte dahinter. Die großen offenen Modelle haben damit aufgeholt: In Teil 1 lag das beste offene Modell sechs Punkte hinter Jev, allerdings liefen dort auch nur kleine Modelle auf dem Laptop.
Wie inzwischen auch pplx-decider und Kev 4B hat Clef offene Gewichte. Wer seine Daten nicht an eine API geben will, kann ein Modell auf diesem Niveau selbst betreiben. Das gab es zum Start von Jev noch nicht. Über Cloudflares eigene API kostet Clef dagegen 0,155 US-Dollar je 1.000 Entscheidungen, viermal so viel wie Jev.
Auch bei der Sicherheit ist Clef besser aufgestellt. Keine einzige Antwort trägt die Sicherheit 100 Prozent, und an den Angaben lässt sich gut ablesen, welche Antworten eher falsch sind.
Über Cloudflare hatte Clef allerdings zwei Schwächen: Es übersah den entscheidenden Satz in langen Texten, und mit zehn Papern pro Anfrage verlor es 20 Punkte. Deshalb habe ich Clef auf einer gemieteten Grafikkarte selbst betrieben, einer Nvidia A100 mit 80 GB Speicher. Bei den 400 Papern gab es in jedem einzelnen Fall dieselbe Antwort wie über Cloudflare. Die beiden Schwächen waren aber weg: Mit zehn Papern pro Anfrage verlor Clef keinen Punkt, und in Texten bis 8.000 Tokens fand es den entscheidenden Satz immer. Das Modell war also nie das Problem, sondern die Art, wie Cloudflare es betreibt, denn dort werden lange Eingaben offenbar stillschweigend gekürzt.
Ganz ohne Grenze ist allerdings auch der Code nicht, den Cloudflare zum Modell mitliefert. Er kürzt jede Eingabe auf 16.384 Tokens, ohne Hinweis. Im längsten Test lag Clef deshalb auch selbst betrieben fast jedes fünfte Mal daneben. Die Grenze lässt sich mit einer Zeile erhöhen. Auf 65.536 Tokens gestellt, fand Clef den Satz auch in den längsten Texten in allen 28 Fällen. Das kostet Zeit: Für einen Text von 24.000 Tokens brauchte Clef auf der A100 im Mittel 11,5 Sekunden statt einer Drittelsekunde für ein Paper.
Genauigkeit trennt die Modelle kaum noch, der Preis schon
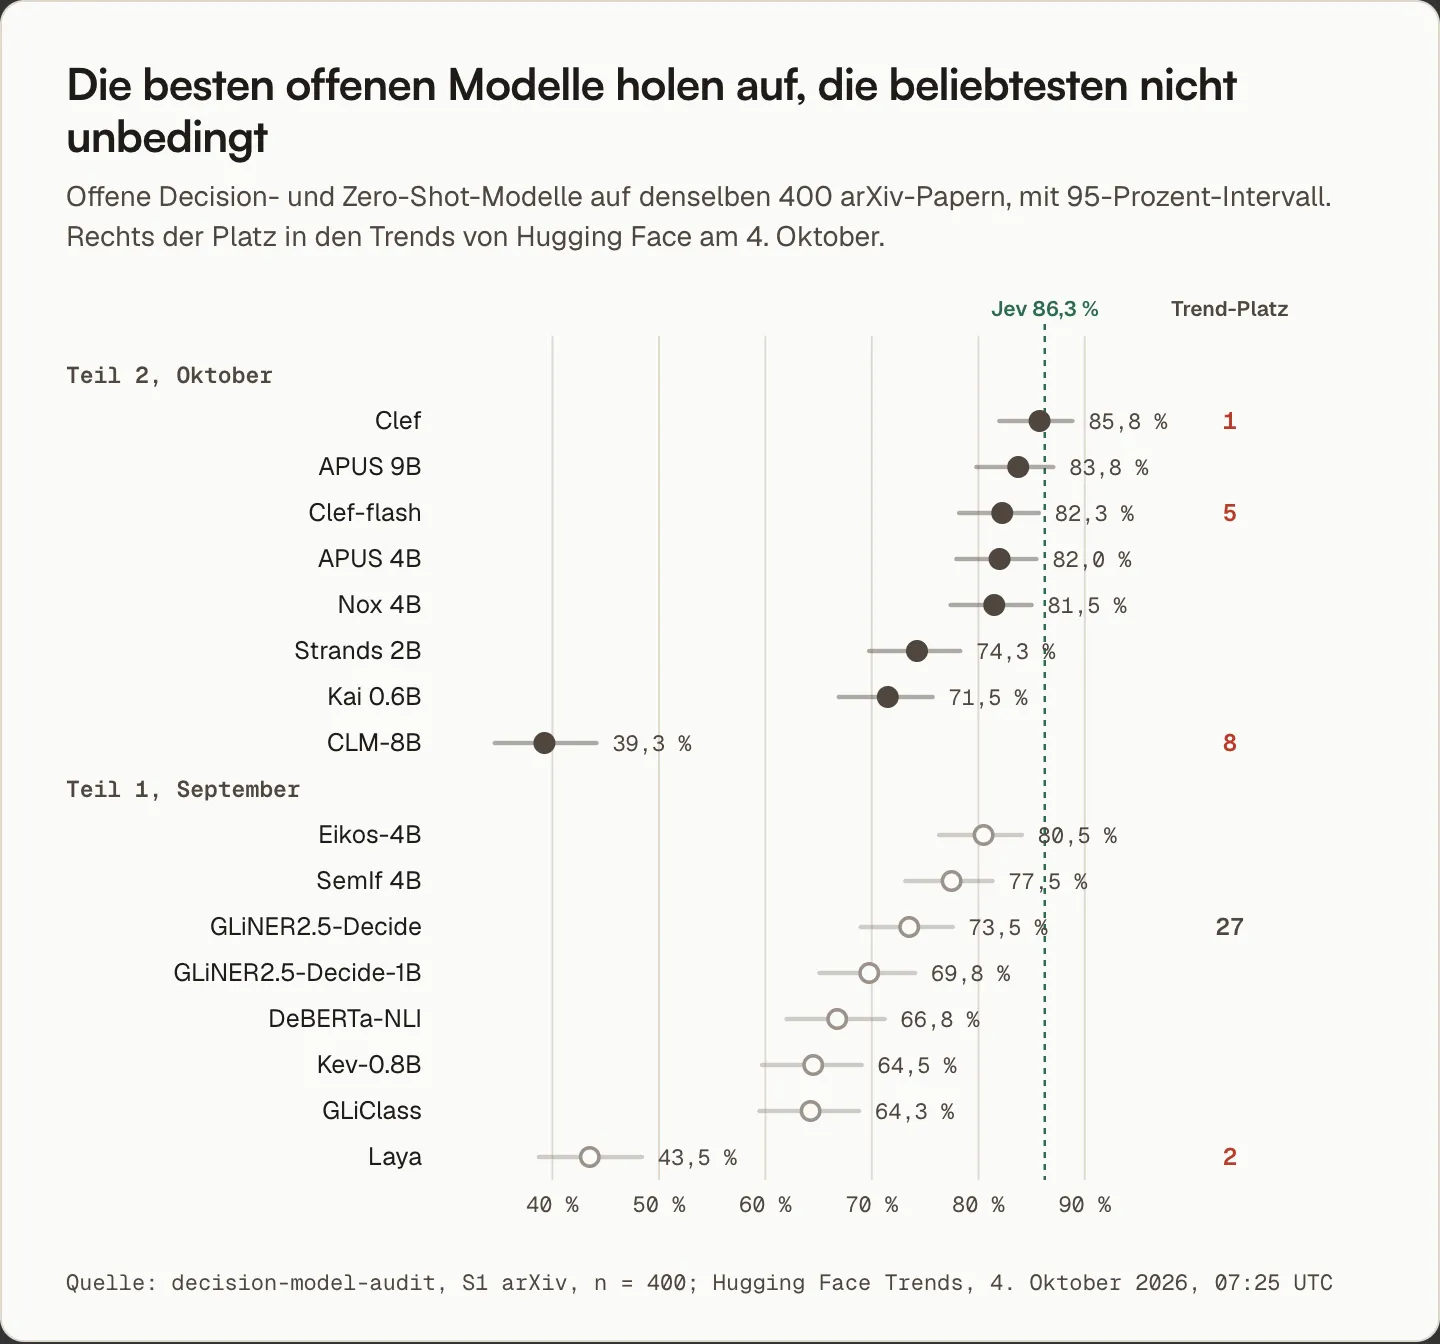
Sechs der 15 Modelle sind auf den 400 Papern nicht von Jev zu unterscheiden, darunter Perplexitys pplx-decider, Fastinos GLiDE und Clef. pplx-decider liegt im Punktwert sogar einen Punkt vor Jev, aber auch das ist kein belastbarer Unterschied. Die übrigen neun liegen 4 bis 47 Punkte dahinter.
Ist die Aufgabe dann einfach zu leicht? Ein Stück weit ja. Schon in Teil 1 lagen die besten Systeme nahe an dem, was die Labels hergeben: Bei fast allen Papern, die alle falsch hatten, einigten sie sich auf dieselbe andere Kategorie als die Autoren. Für die Praxis ist das trotzdem aussagekräftig. Viele Zuordnungsaufgaben im Unternehmen dürften ähnlich einfach sein, etwa Tickets einer Abteilung zuzuordnen. Dort zählt vor allem, was nach der Genauigkeit kommt.
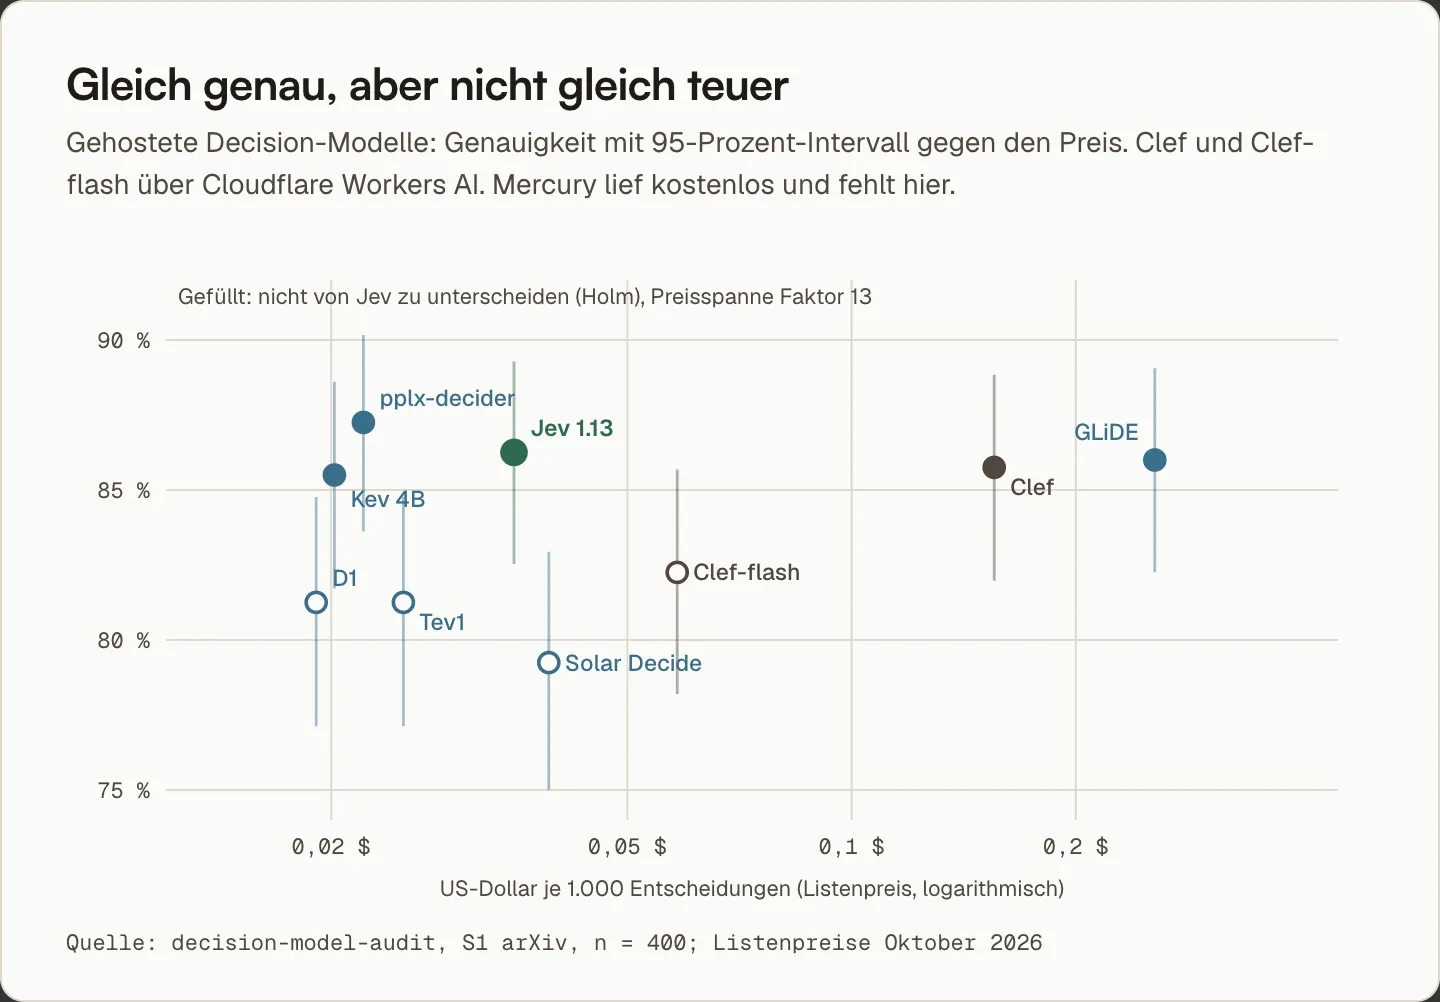
Zum Beispiel der Preis. Unter den gleich genauen Modellen kosten 1.000 Entscheidungen zwischen 2 und 26 Cent, also bis zum 13-Fachen. Jev liegt mit 3,5 Cent im unteren Feld.
In der Praxis: Wählen Sie ein Decision-Modell nicht nach der Genauigkeit auf einer Rangliste. Bei einfacher Klassifikation sind viele gleich gut. Entscheidend ist, wie sich das Modell im Betrieb verhält und was es kostet.
Gleiche Schnittstelle, anderes Verhalten
Alle Modelle bekamen exakt dieselbe Anfrage. Die Antworten sehen gleich aus, bedeuten aber nicht dasselbe.
Die Sicherheitsangabe. Jede Antwort enthält ein Feld namens confidence. Nur weil es so heißt, ist es noch keine Sicherheit, auf die man sich verlassen kann. Bei manchen Anbietern ist es die Wahrscheinlichkeit der gewählten Antwort, bei anderen eine daraus abgeleitete Kennzahl. Wer darauf einen Schwellenwert baut, etwa „unter 80 Prozent prüft ein Mensch“, muss ihn bei jedem Anbieterwechsel neu bestimmen.
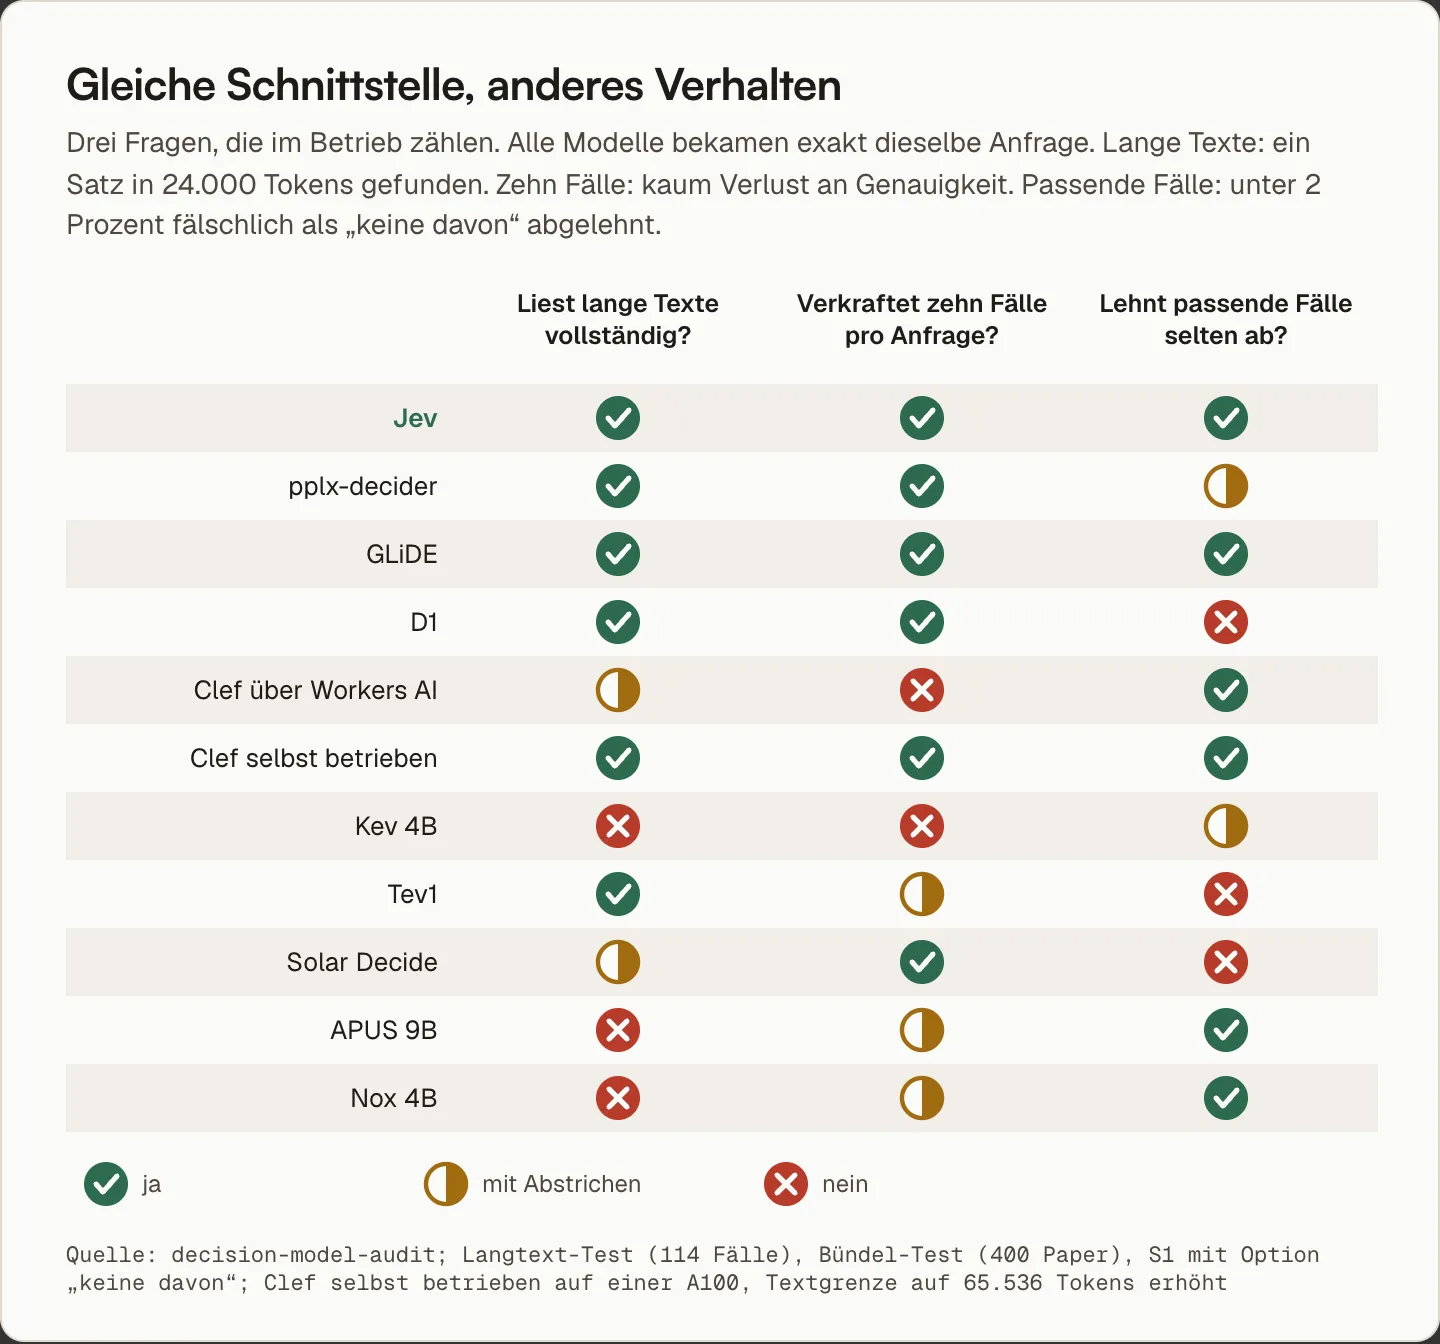
Lange Texte. In einem langen Verwaltungstext von bis zu 24.000 Tokens, also etwa 18.000 Wörtern, stand ein einziger entscheidender Satz. Nur Jev, pplx-decider, GLiDE und D1 fanden ihn bei jeder Länge, dazu das selbst betriebene Clef, sobald man seine Textgrenze erhöht. Andere Modelle lehnen lange Texte einfach ab.
Viele Fälle pro Anfrage. Schickt man zehn Paper in einer Anfrage statt zehn einzelner, halten manche Modelle ihre Genauigkeit, andere verlieren bis zu 50 Punkte. Auch der Preis dreht sich: Bei Jev wird das Bündeln billiger, bei den meisten anderen Anbietern deutlich teurer.
Keine passende Kategorie. Mit einer Option „keine davon“ erkennen fast alle Modelle Paper, die in keine Kategorie passen. Manche lehnen dafür aber auch viele Paper ab, die sehr wohl passen, Solar Decide fast jedes dritte.
In der Praxis: Ein Anbieterwechsel ist bei Decision-Modellen ein Modellwechsel, auch wenn der Code gleich bleibt. Prüfen Sie vorher, was die Felder bedeuten, wie lange Texte behandelt werden und was eine gebündelte Anfrage kostet.
Wie viele Fälle ein Modell allein entscheiden kann
Die eigentliche Frage im Betrieb ist selten, wie genau ein Modell insgesamt ist. Sie lautet: Welche Fälle kann ich ihm ohne Prüfung überlassen?
Ein Beispiel: Ein Modell mit 86 Prozent Genauigkeit liegt bei etwa jedem siebten Fall falsch. Lässt man es nur die Fälle allein entscheiden, bei denen es sich am sichersten ist, und gibt den Rest an Menschen, sinkt die Fehlerquote unter den automatisch entschiedenen Fällen. Ich habe gemessen, welchen Anteil der Fälle ein Modell so übernehmen kann, wenn dort höchstens jeder zwanzigste Fall falsch sein darf, also 5 Prozent.
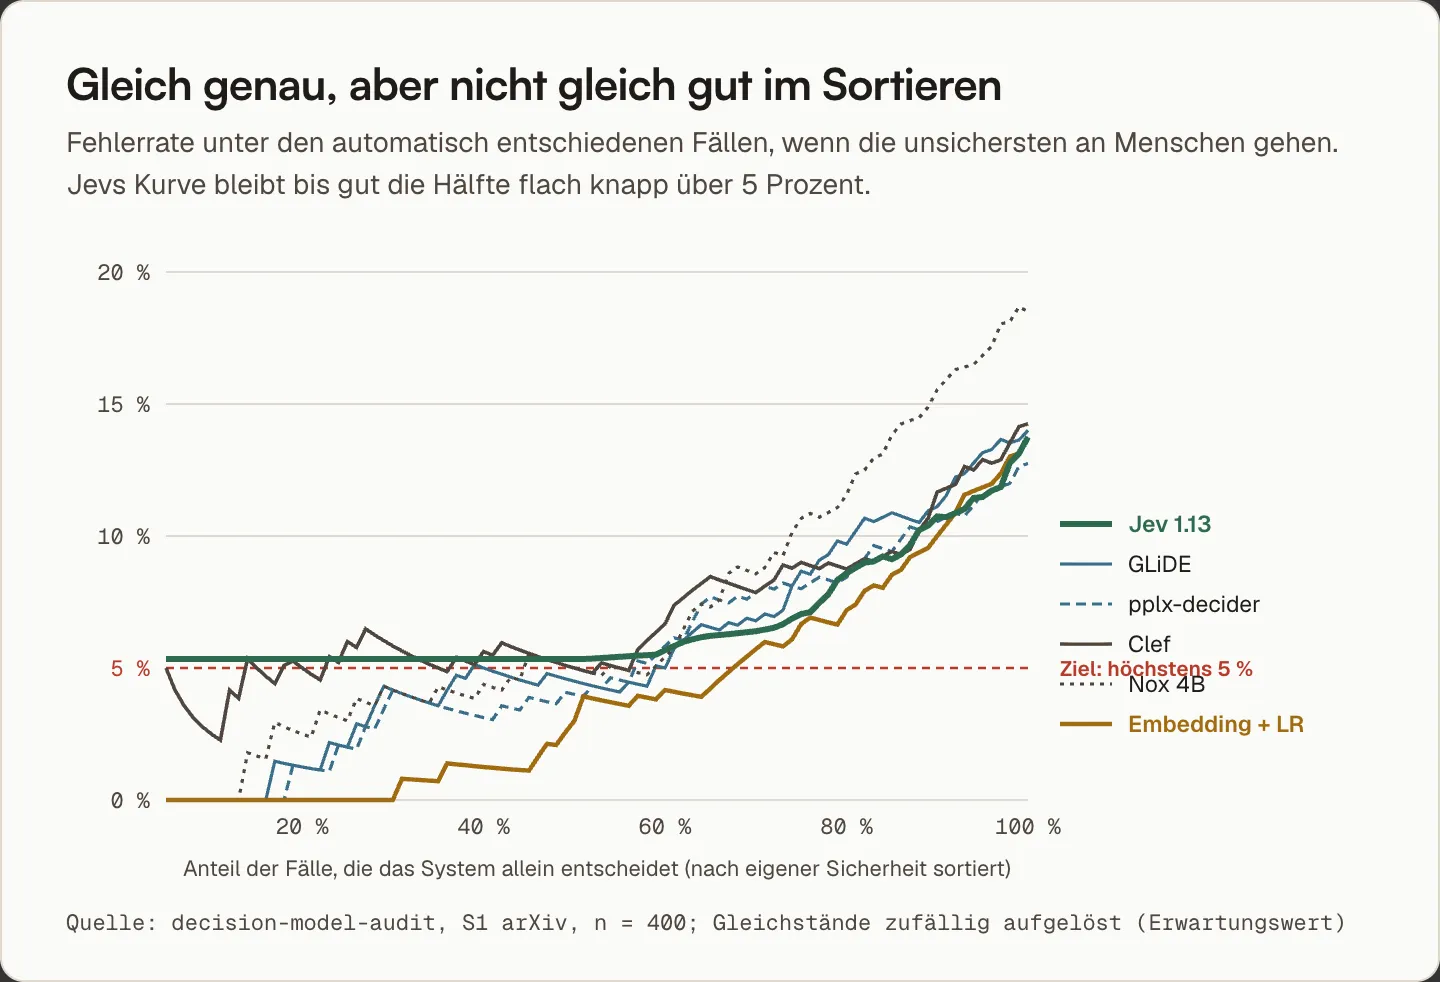
Gleich genaue Modelle unterscheiden sich hier stark. GLiDE, Clef und pplx-decider könnten jeweils gut die Hälfte der Fälle übernehmen. Jev keinen einzigen. Der Grund ist der Befund aus Teil 1: Jev gibt der Hälfte aller Antworten die Sicherheit 100 Prozent, und in dieser Hälfte sind gut 5 Prozent falsch. Diese Hälfte lässt sich nicht weiter sortieren. Bei einem Ziel von 5 Prozent bleibt deshalb nichts übrig, bei 5,5 Prozent wäre es schon die Hälfte. Alles oder nichts.
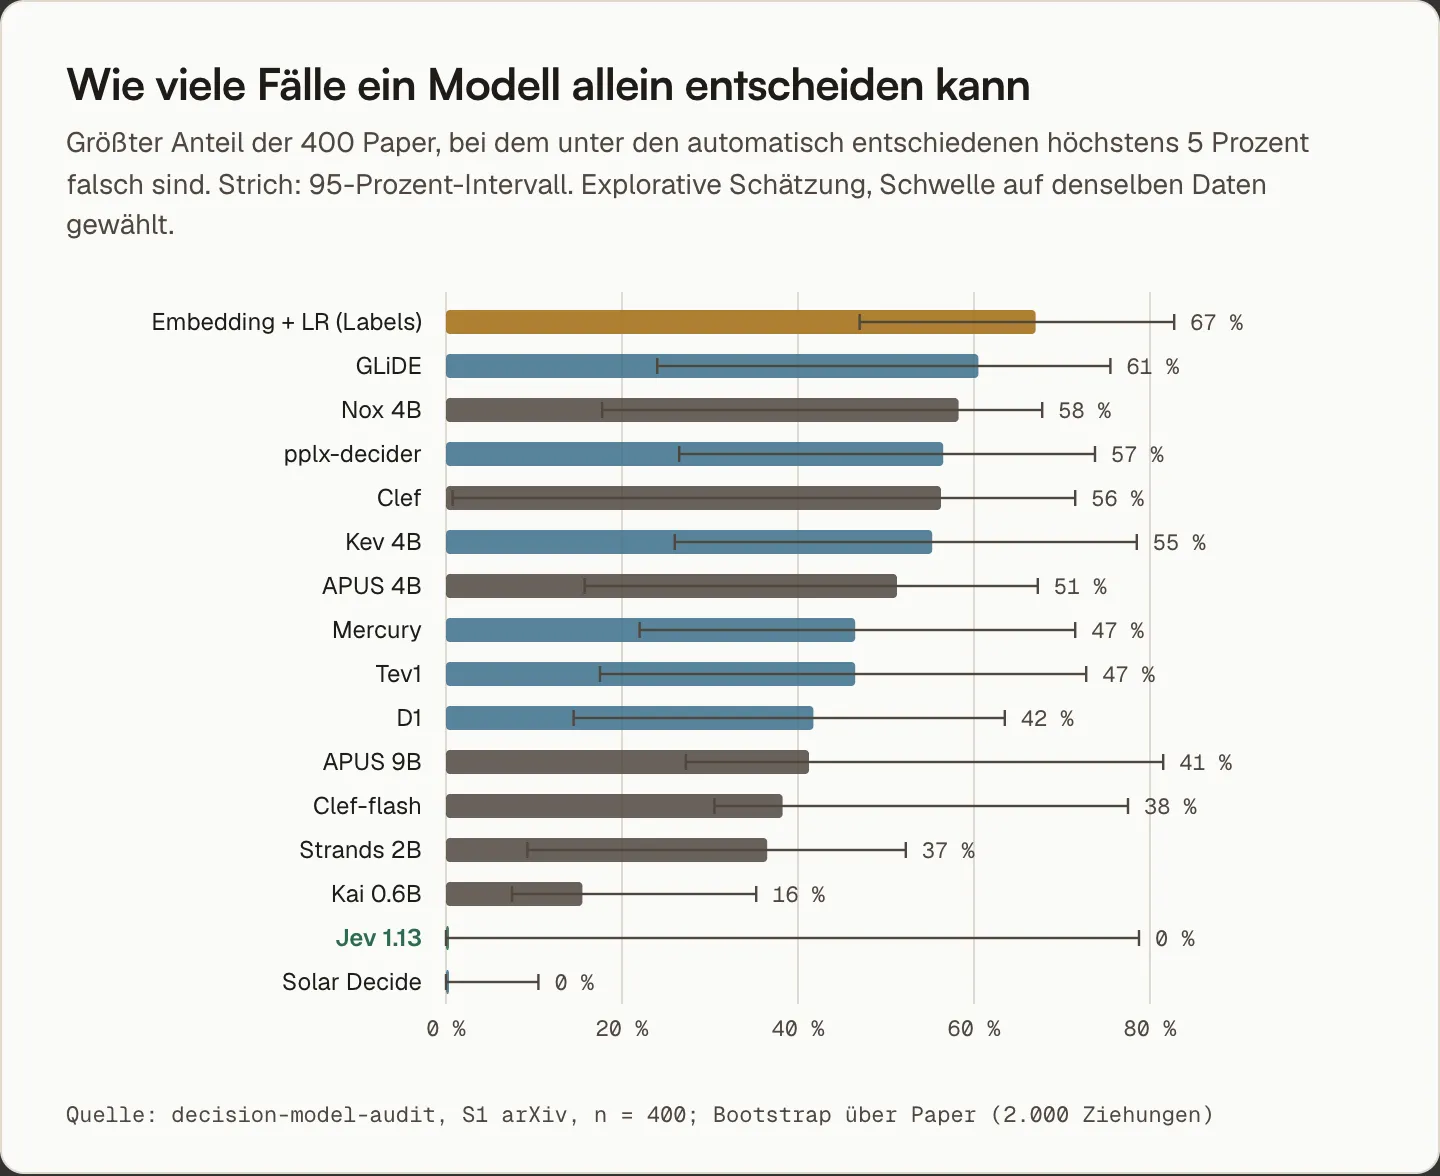
Diese Zahlen sind eine Schätzung mit großer Unsicherheit. Sie zeigen, dass sich gleich genaue Modelle gerade in der Eigenschaft unterscheiden, auf die es beim Automatisieren ankommt. Wie viel ein Modell bei Ihnen übernehmen kann, sagen sie nicht voraus.
Fairerweise gehört dazu: Nennt man dem Modell ausdrücklich eine Chance, etwa eine Urne mit sieben roten und drei blauen Kugeln, gibt Jev die Wahrscheinlichkeit genauer wieder als jedes andere Decision-Modell. Jevs Problem sind nicht Wahrscheinlichkeiten an sich, sondern das Einschätzen der eigenen Fehler.
In der Praxis: Messen Sie vor dem Einsatz auf einigen hundert eigenen Fällen, wie viele das Modell bei Ihrer tolerierbaren Fehlerquote allein entscheiden kann. Diese Zahl bestimmt, wie viel Arbeit Sie sparen, und sie kann zwischen gleich genauen Modellen um ein Vielfaches schwanken.
Wechselnde Optionen: die eigentliche Stärke, selten gebraucht
Eine Korrektur zu Teil 1 gehört hierher. Dort stand, eine Auswahlfrage sei klassische Klassifikation. Das stimmt, solange die Optionen fest sind. Ein Decision-Modell kann aber Optionen bekommen, die sich von Fall zu Fall ändern, und das kann ein klassischer Klassifikator nicht. Das ist der Kern dessen, was Decision-Modelle mehr können.
Im Test funktionierte das gut. Beim Wählen des richtigen Titels unter fünf ähnlichen lagen fast alle Decision-Modelle bei 97 bis 99 Prozent. Allerdings schaffte ein einfacher Vergleich über Embeddings, ganz ohne Training, ebenfalls 97 Prozent. Decision-Modelle können wechselnde Optionen also verarbeiten, das bessere Werkzeug waren sie dafür in diesem Test aber nicht. Ob sich das bei schwierigeren Optionen ändert, habe ich nicht gemessen.
Wie oft braucht man das in der Praxis? Meiner Erfahrung nach selten, und gerade nicht bei den beworbenen Fällen wie dem Routing von E-Mails oder Tickets. Dort gibt es feste Kategorien. Wechselnde Optionen kommen vor allem vor, wenn ein AI-Agent aus vielen Werkzeugen eines auswählen muss oder Datensätze gegeneinander abgeglichen werden. Auch dort lösen selbst die Anbieter das meist in zwei Schritten: Eine einfache Suche wählt eine kurze Liste aus, das Modell prüft dann jeden Kandidaten einzeln. So beschreiben es auch TypeSafes eigene Anleitungen. (TypeSafe, Doku, Anthropic)
Bei den beiden anderen neuen Aufgaben zeigte sich ein gemischtes Bild. Behauptungen gegen einen Text zu prüfen, gelang den meisten Modellen gut, nur kleine Modelle stolperten über veränderte Zahlen. Das Zählen von Ereignissen in einem Protokoll war dagegen für alle schwer. Selbst die besten trafen nur knapp zwei Drittel der Stufen.
Deutsch kostet kaum Genauigkeit
Den Sprachtest habe ich nur mit zehn gehosteten Modellen gemacht. Auf den 600 FWF-Projekten blieben neun davon zwischen Deutsch und Englisch innerhalb eines Prozentpunkts. Die Modelle kommen mit deutschen Texten also gut zurecht. Deutsche Texte sind allerdings länger: Sie brauchen ein Fünftel bis ein Drittel mehr Tokens, und bei Abrechnung nach Tokens kosten sie entsprechend mehr.
Zwei Einschränkungen: Die beiden Zusammenfassungen eines Projekts sind keine Übersetzungen, die Antragsteller schreiben sie getrennt. Der Test vergleicht also die Sprachen so, wie Antragsteller sie schreiben, nicht reine Übersetzungen. Und die Texte sind seit Längerem öffentlich, die Modelle könnten sie also schon kennen. Das verzerrt den Sprachvergleich nicht, weil jedes Projekt in beiden Sprachen vorkommt, wohl aber die absolute Genauigkeit.
Mit Labels reicht eine einfache Baseline
In Teil 1 kam eine einfache Baseline aus Embeddings und logistischer Regression mit 400 gelabelten Beispielen fast an Jev heran. Die Beispiele zum Trainieren waren dort 2.806 Paper aus dem Jahr 2024, getrennt von den 400 Testpapern aus dem September 2026. Daraus wurden für die Lernkurve unterschiedlich große Stichproben gezogen. Daraus folgt eine Frage, die mich seit Teil 1 beschäftigt: Manche Decision-Modelle, etwa Laya, werden ausdrücklich als Grundlage zum Nachtrainieren angeboten. Warum sollte man ein Decision-Modell verwenden, wenn man es ohnehin trainieren muss? Dann kann man auch gleich mit einem gewöhnlichen Modell starten.
Ich habe das nachträglich getestet. Laya und ModernBERT, das Modell, auf dem Laya aufbaut, wurden mit denselben Labels nachtrainiert. ModernBERT bekam dafür einen gewöhnlichen Klassifikationskopf.
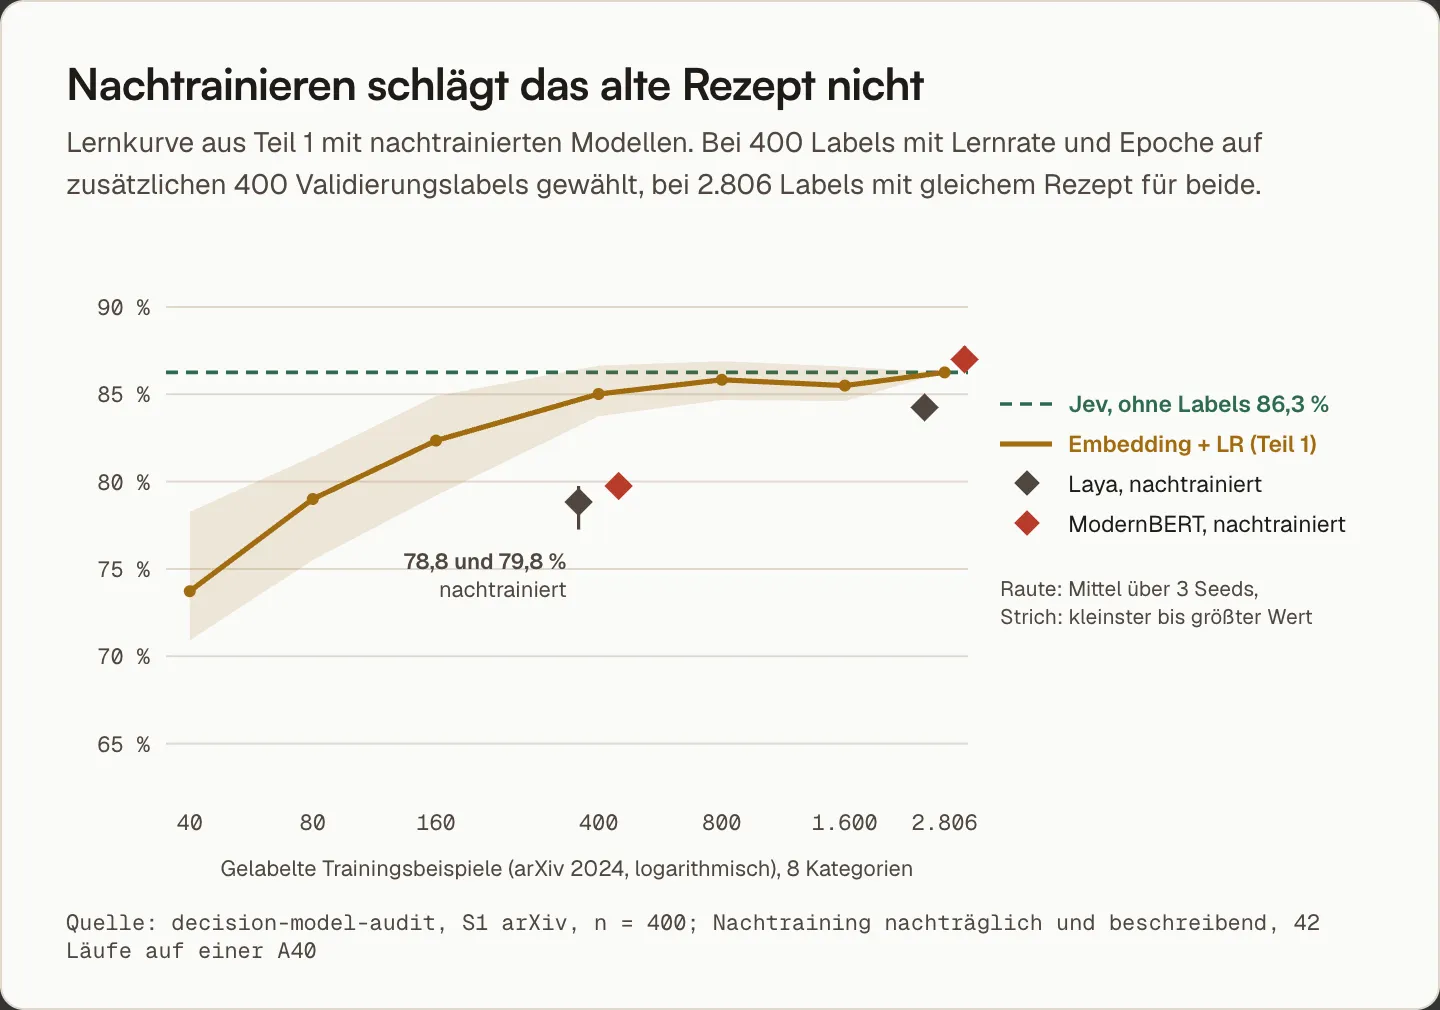
Mit 400 Labels kamen beide auf knapp 80 Prozent, die Baseline auf 85. Mit allen 2.806 Labels lag das gewöhnliche Modell bei 87 Prozent, Laya bei 84. Das Vortraining als Decision-Modell brachte also keinen Vorteil.
Lehrreicher als das Ergebnis ist der Weg dorthin. Damit das Nachtrainieren überhaupt stabil lief, brauchte es eine ganze Pipeline mit den üblichen Werkzeugen des Machine Learning: die passende Lernrate suchen, ein eigenes Validierungsset zurückhalten, die beste Trainingsdauer auswählen und jede Einstellung mehrmals mit anderem Zufallsstart wiederholen. Das waren 42 Trainingsläufe und rund fünf Stunden auf einer gemieteten Nvidia A40, nur um bei knapp 80 Prozent zu landen. Die Baseline trainiert auf fertigen Embeddings in Sekunden, ohne Grafikkarte und ohne Validierungsset, und liegt fünf Punkte vorn.
Wer sich für das Nachtrainieren entscheidet, sollte das wissen. Zu den Labels kommen Experimente, Rechenzeit und Fachwissen. Bei großen Sprachmodellen dürfte der Aufwand eher noch größer sein, gemessen habe ich das nicht.
In der Praxis: Wenn Sie Labels und feste Kategorien haben, trainieren Sie zuerst die einfache Baseline. Ein Decision-Modell nachzutrainieren hat sich in diesem Test nicht gelohnt.
Welches Modell ich für welche Lage empfehle
Die Empfehlungen gelten für das, was ich gemessen habe: Zuordnung von Texten zu festen Kategorien auf Englisch und Deutsch, Stand Oktober 2026. Gehostete Modelle können sich jederzeit ändern, und wie viele Fälle ein Modell allein entscheiden kann, ist eine Schätzung.
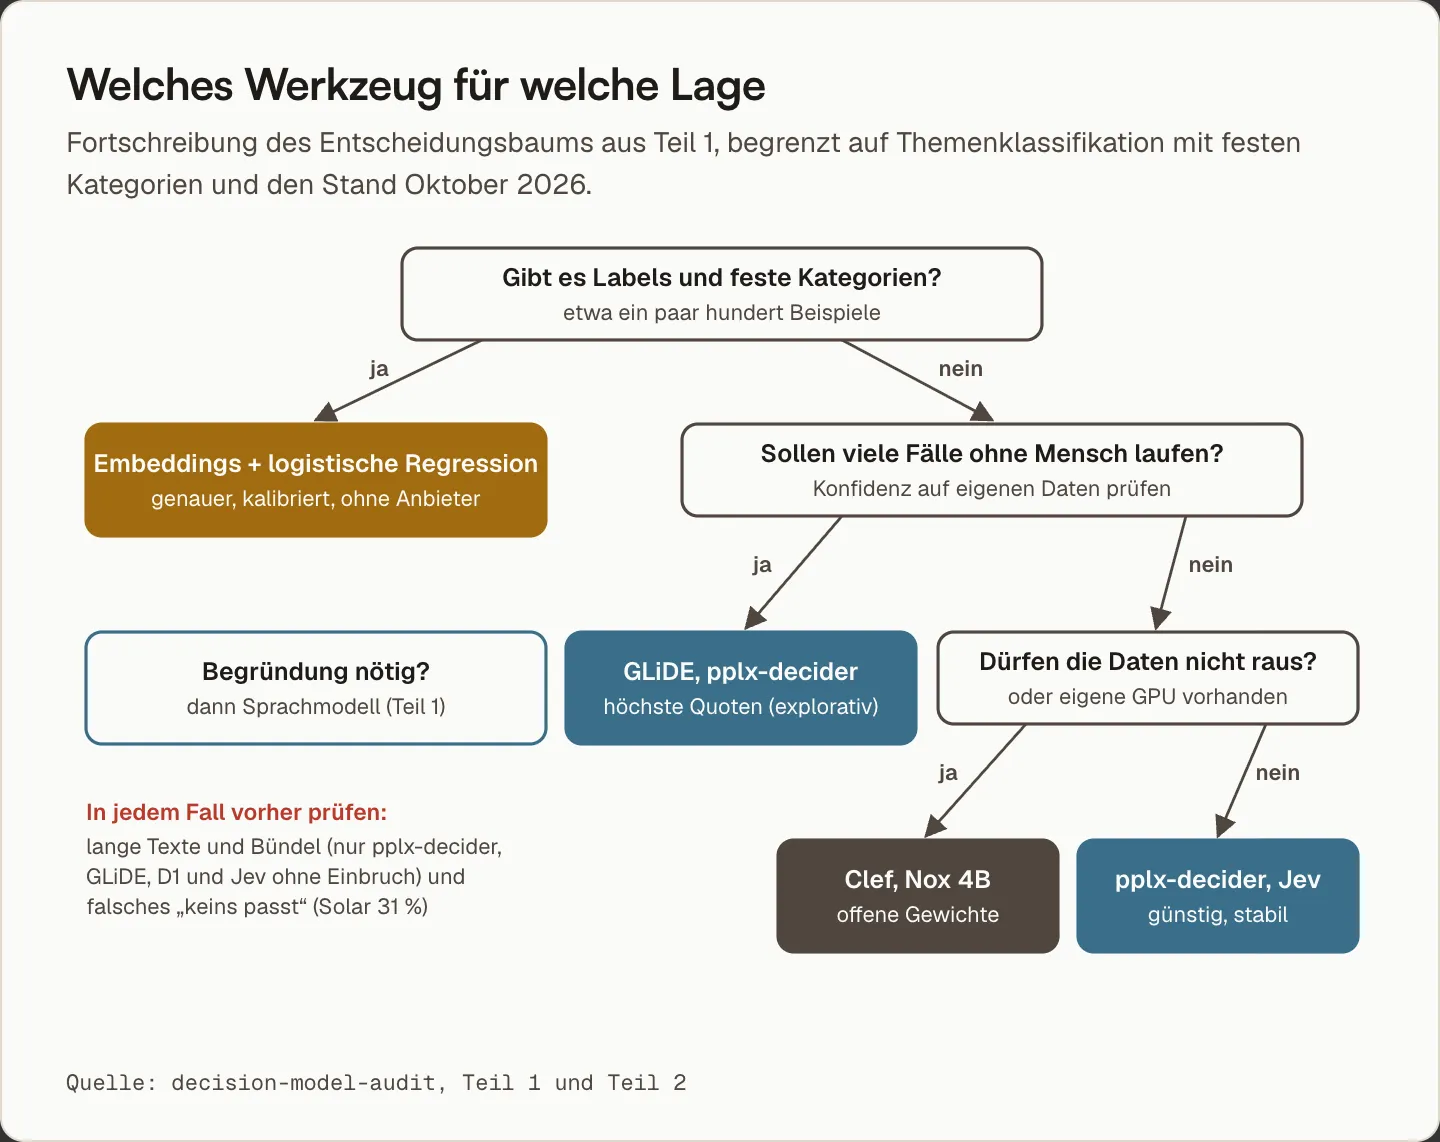
- Sie haben Labels und feste Kategorien: Testen Sie zuerst die einfache Baseline aus Embeddings und logistischer Regression. Sie war in diesem Test bei 400 Labels genauer als jedes nachtrainierte Modell und am besten darin, die eigene Unsicherheit einzuschätzen.
- Keine Labels, gehostet, Preis zählt: pplx-decider von Perplexity. So genau wie Jev, mit 2,2 Cent je 1.000 Entscheidungen unter den günstigsten, und liest lange Texte vollständig. Gebündelte Anfragen kosten allerdings ein Vielfaches.
- Viele Fälle sollen ohne Mensch laufen: GLiDE von Fastino oder pplx-decider. Beide konnten in meiner Schätzung gut die Hälfte der Fälle allein übernehmen, GLiDE ist aber das teuerste Modell. Prüfen Sie den Anteil auf Ihren eigenen Daten.
- Hohes Volumen, gebündelte Anfragen, ein Mensch prüft mit: Jev ist weiterhin eine gute Wahl. Es bleibt bei umformulierten Kategorien am stabilsten und wird im Bündel billiger. Fälle ganz ohne Prüfung übernehmen konnte Jev bei höchstens 5 Prozent Fehlern in meinem Test allerdings nicht.
- Die Daten dürfen nicht nach außen: Clef von Cloudflare mit offenen Gewichten, auf eigener Hardware. Erhöhen Sie die Textgrenze im mitgelieferten Code, sonst kürzt Clef lange Texte ohne Hinweis. Für kleinere Grafikkarten ist Decision 2.0 Nox 4B eine Alternative, die allerdings sehr lange Texte ablehnt. pplx-decider und Kev 4B gibt es ebenfalls mit offenen Gewichten, getestet habe ich beide aber nur über ihre APIs.
- Jemand muss die Entscheidung nachvollziehen: ein Sprachmodell mit Begründung, wie in Teil 1. Decision-Modelle begründen nicht.
Für diese Art von Aufgabe weniger geeignet waren Solar Decide, das viele passende Fälle ablehnte, und Kev 4B bei langen oder gebündelten Texten. CLM und Laya sind für andere Zwecke gebaut, für die Auswahl von Agenten-Aktionen und als Grundlage zum Nachtrainieren.
Was das zeigt und was nicht
Der Test deckt vor allem eine Aufgabenart ab: Texte acht festen Kategorien zuordnen. Die neuen Aufgaben sind konstruiert und teils nahe daran, dass alle Modelle sie lösen. Entscheidungen mit Regeln, Ausnahmen oder mehreren zusammenhängenden Fragen habe ich nicht geprüft, Bilder ebenfalls nicht, obwohl Clef sie lesen kann. Alles in diesem Teil ist gegenüber Teil 1 nachträglich, jeder Schritt ist protokolliert, und Schritte, die ich erst nach Zwischenergebnissen entschieden habe, sind im Repository markiert.
Gehostete Modelle haben oft keine öffentliche Versionsnummer und können sich jederzeit ändern. Lokale Modelle liefen auf einem Laptop mit 16 GB Arbeitsspeicher, Nox 4B und das Nachtraining auf einer Nvidia A40, das selbst betriebene Clef auf einer Nvidia A100. Antwortzeiten sind zwischen diesen Aufbauten nicht vergleichbar. Die Zahlen von Hugging Face sind eine Momentaufnahme vom 4. Oktober.
Wie dieser Text entstanden ist
Die Experimente liefen vom 2. bis 4. Oktober 2026, die lokalen Modelle über Nacht auf dem Laptop, einige Modelle und das Nachtraining auf gemieteten Grafikkarten, die die Agenten selbst betrieben und danach wieder gelöscht haben. Wie in Teil 1 haben AI-Agenten in Claude Code die Arbeit erledigt: Claude Opus 5.5 hat geplant, Code geschrieben, die Läufe gesteuert, recherchiert und den Text entworfen. Codex mit GPT-6 Sol hat den Bericht, die Kernzahlen und den Aufbau dieses Textes unabhängig geprüft. Ich habe die Fragestellung vorgegeben, jede Entscheidung über Modelle, Daten und Budget getroffen, Zwischenergebnisse geprüft und den Text überarbeitet.
Brauchen Sie überhaupt ein Decision-Modell?
Für die Aufgabe, die ich gemessen habe, Texte festen Kategorien zuzuordnen, lautet die Antwort: Wenn Sie Labels haben, wahrscheinlich nicht. Testen Sie zuerst die einfache Baseline. Sie war in diesem Test besser als jedes nachtrainierte Decision-Modell und in Sekunden trainiert.
Wenn Sie keine Labels haben, kann ein Decision-Modell ein guter Start sein. Jev ist das weiterhin, aber nicht mehr die einzige gute Wahl. Bei der Genauigkeit sind viele gleichauf, inzwischen auch mit offenen Gewichten. Wählen Sie nach dem, was danach kommt: wie viele Fälle das Modell auf Ihren Daten allein entscheiden kann, wie es mit langen Texten und gebündelten Anfragen umgeht und was es kostet.
Ihre eigentliche Stärke spielen Decision-Modelle erst aus, wenn sich die Optionen von Fall zu Fall ändern, etwa wenn ein Agent aus vielen Werkzeugen wählt. Das kommt seltener vor, als das Marketing nahelegt, und selbst dort war in meinem Test ein einfacher Vergleich über Embeddings fast gleich gut.
Der Schluss von Teil 1 gilt also weiter, mit einer Ergänzung: Wer noch keine Labels hat, hat inzwischen die Wahl. Die Genauigkeit entscheidet sie kaum noch. Soll das Modell Fälle allein entscheiden, zählt vor allem, wie gut es seine eigenen Fehler einschätzt.
Der vollständige Test, alle Daten, jede Modellantwort und die Auswertung liegen im öffentlichen Begleit-Repository: decision-model-audit. Dort steht auch jede Abweichung vom ursprünglichen Plan, damit Sie die Ergebnisse nachprüfen können, statt mir glauben zu müssen.
Quellen
Teil 1 und Begleit-Repository: Ist Jev wirklich gut? Ein Feldtest auf frischen Daten; decision-model-audit, Bericht results/REPORT-part2.md
TypeSafe und Jev: Ankündigung; Website; System One in der Doku; Einführung in Machine Learning; Doku-Übersicht; Finanzierung, DCVC
Neue Decision-Modelle: Cloudflare Clef, Clef auf Hugging Face; Perplexity pplx-decider; Fastino GLiDE; Liquid D1 auf OpenRouter; Decision 2.0 Nox 4B; APUS-OpenJev; Strands Decider; CLM; Laya; ModernBERT-large
Entwicklung und Einordnung: Jev Decision Index; The Decoder zur Decisions-API von OpenAI; Anthropic zur Werkzeugsuche für Agenten
Daten: FWF Open API; arXiv wie in Teil 1

Stehen Sie vor einem komplexen Problem? Vor jeder Zeile Code: ein Gespräch. Kein Pitch, keine Verpflichtung.
Gespräch buchen